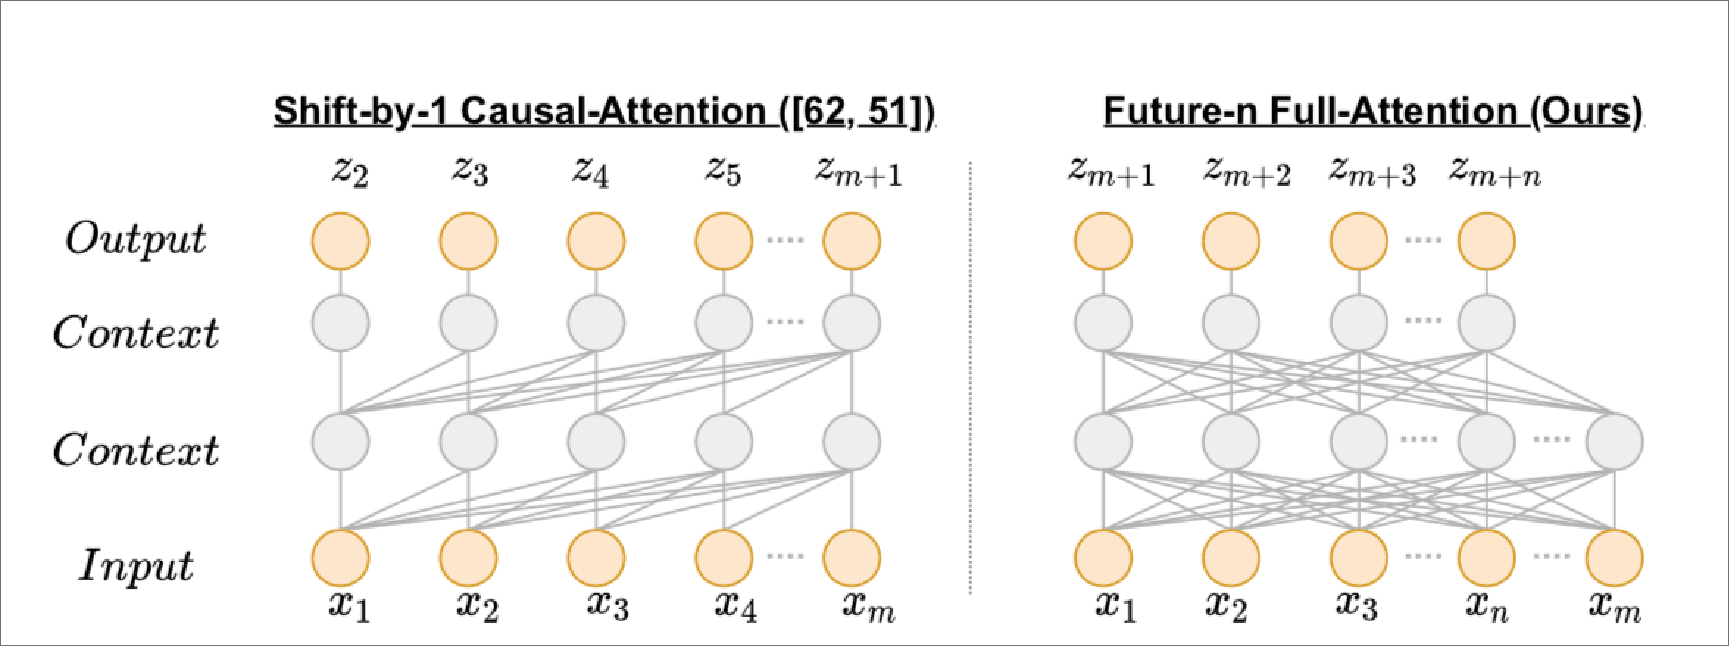
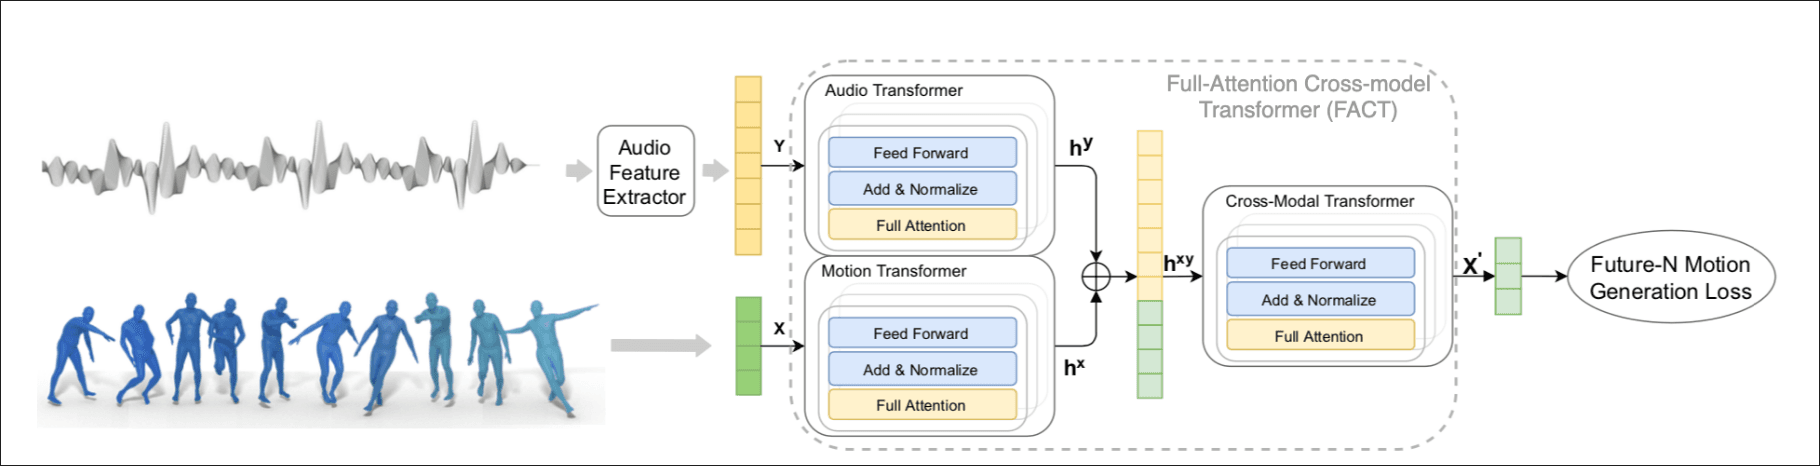
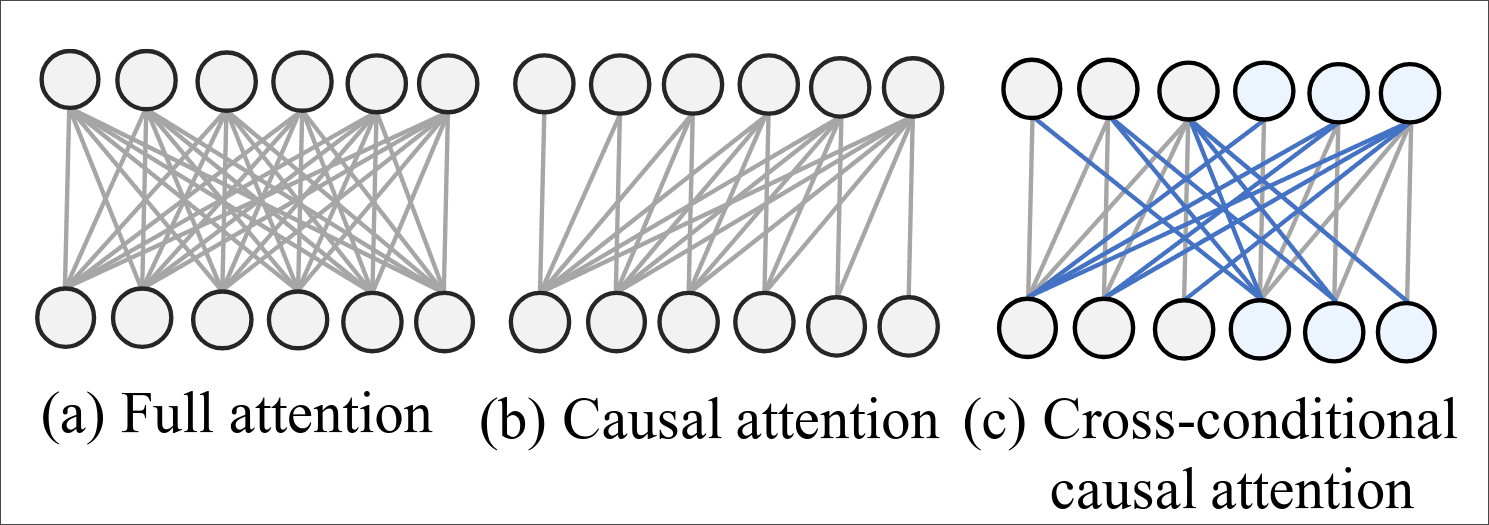
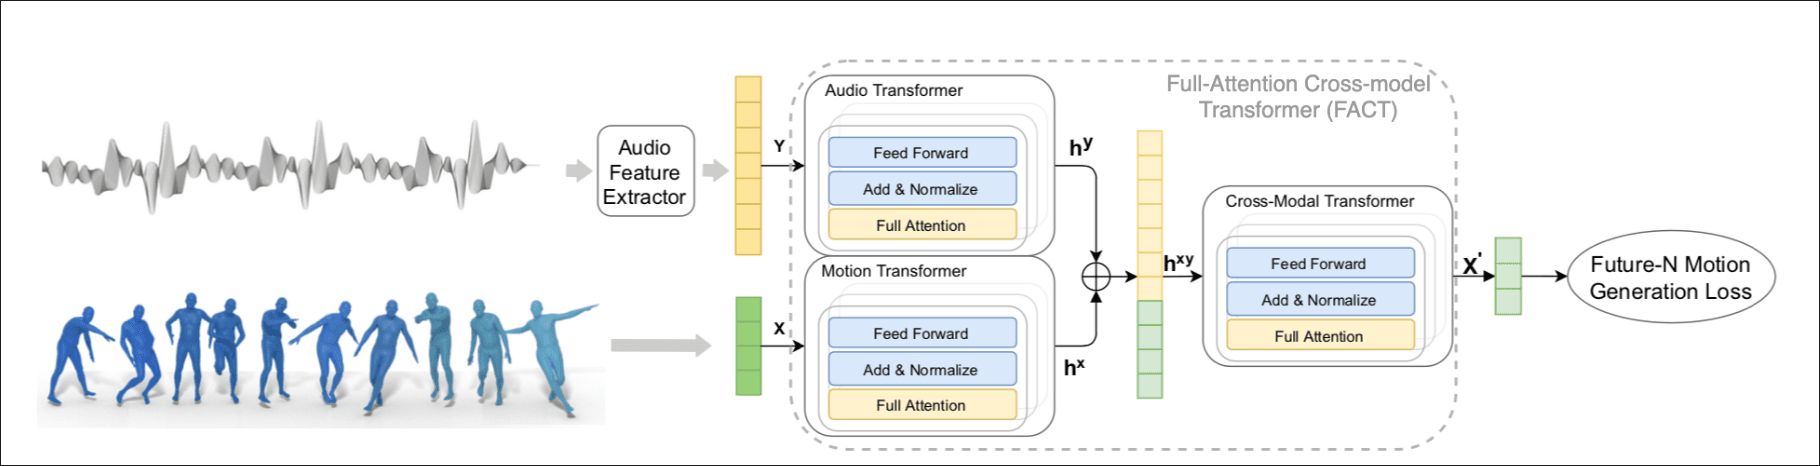
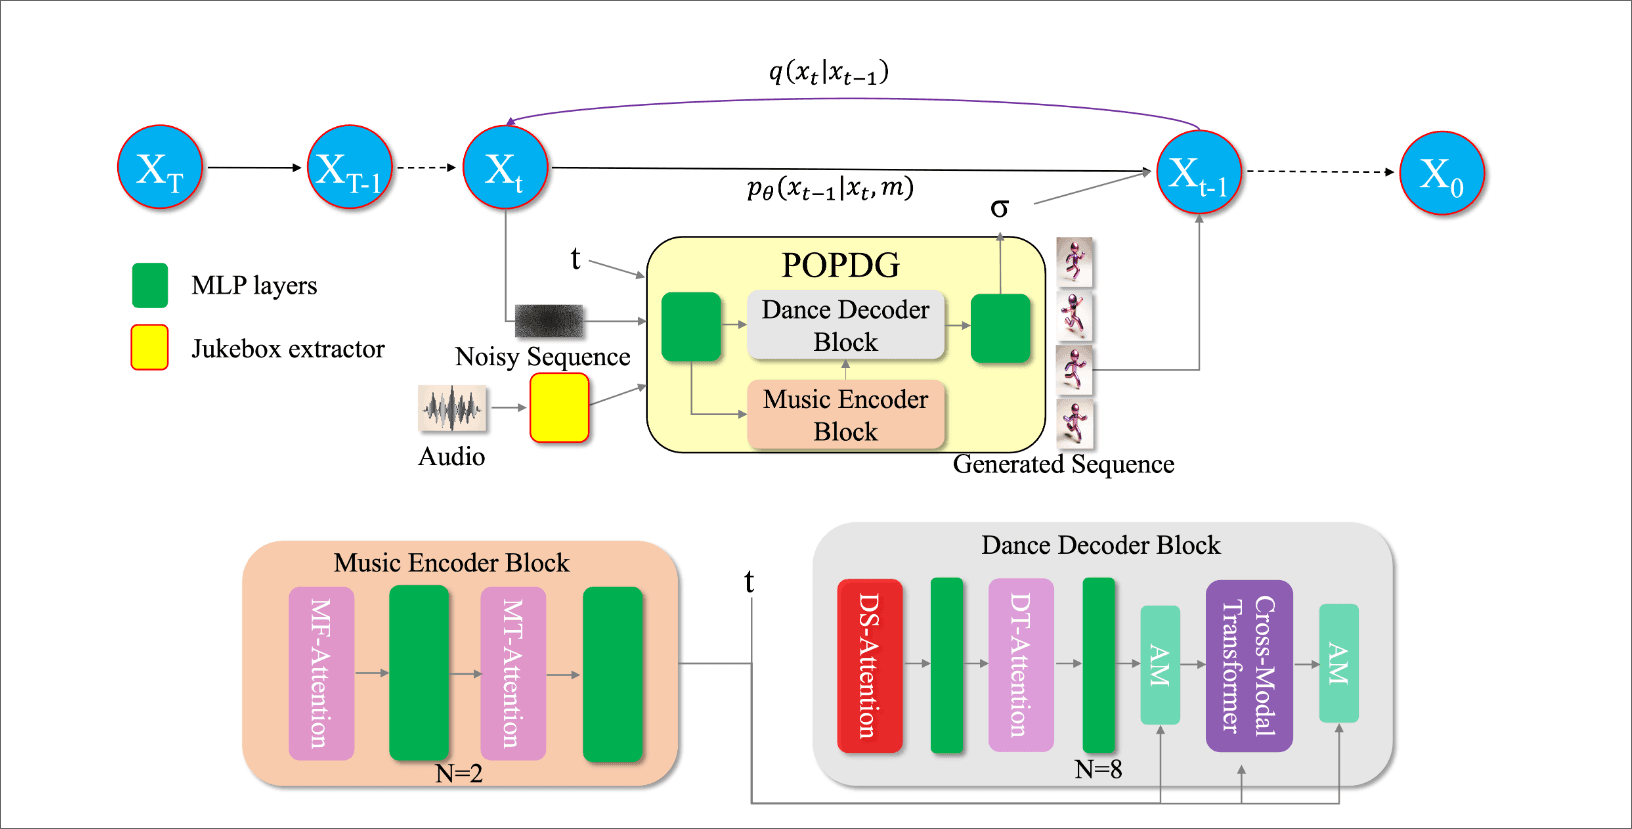
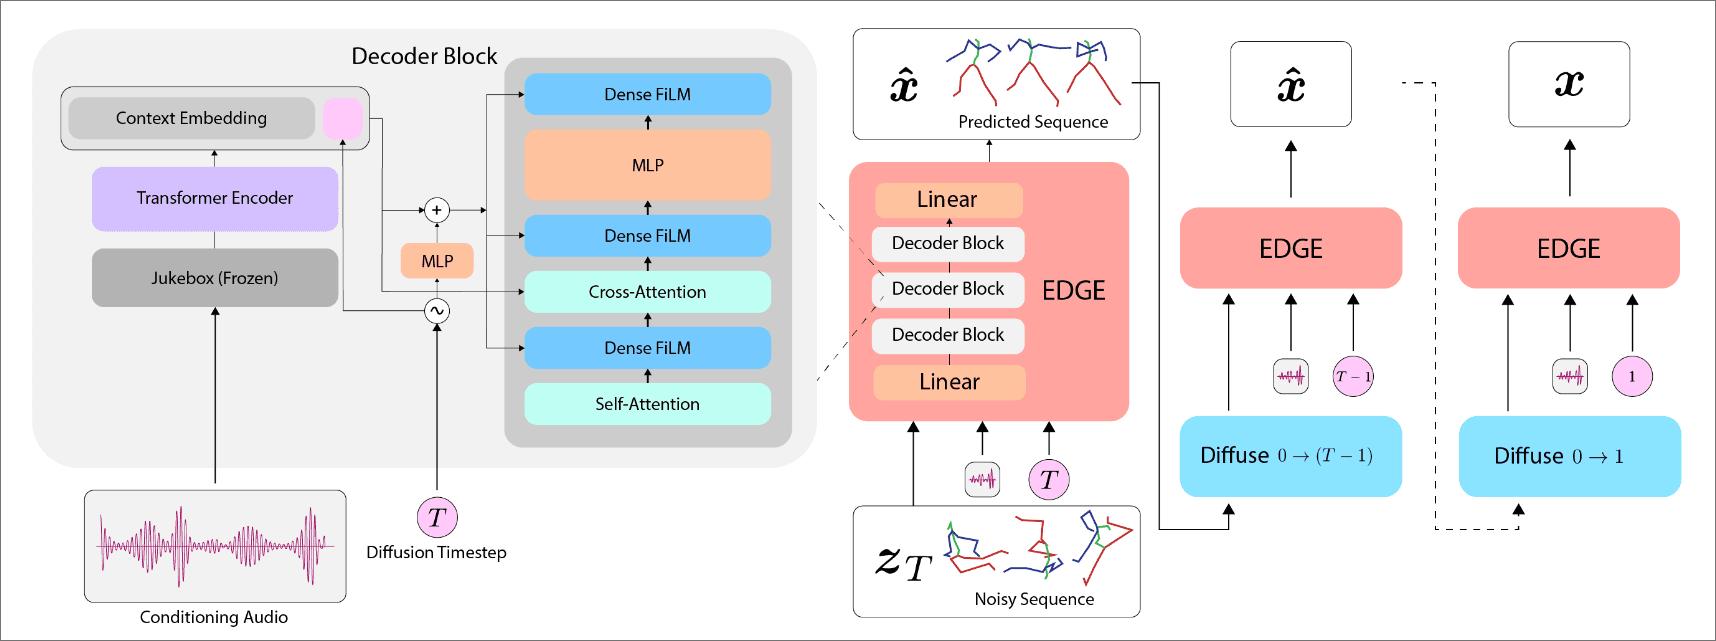
作者使用transformer去捕捉music和motion之间的关系, 然后将预测到的motion用于指导diffusion生成高保真的图片, 号称是业界首个根据一张图片生成舞蹈视频的实践
在处理motion中, 作者将motion分成左手, 右手, 头部, 等5个部分, 为了更好的捕捉到手部和脸部的特征, 太可惜了, 在看aist++那篇论文(应该是这篇, 反正是随记不用负什么责任就不回去考证了)时, 作者将motion分为了上下两部分时取得了更好的效果, 我也想到了类似的做法
当时师兄跟我解释了使用根坐标和转轴代替一个个独立的坐标来表示motion, 我的理解是相当于给了模型一部分先验知识, 告诉了模型一个"人"应该是怎样的, 节点之间有怎样的关系, "跳舞"实际就是节点间角度的变换, 而节点间的距离是没法改变的, 后续我们甚至可以通过改变关节间的距离来匹配不同的人
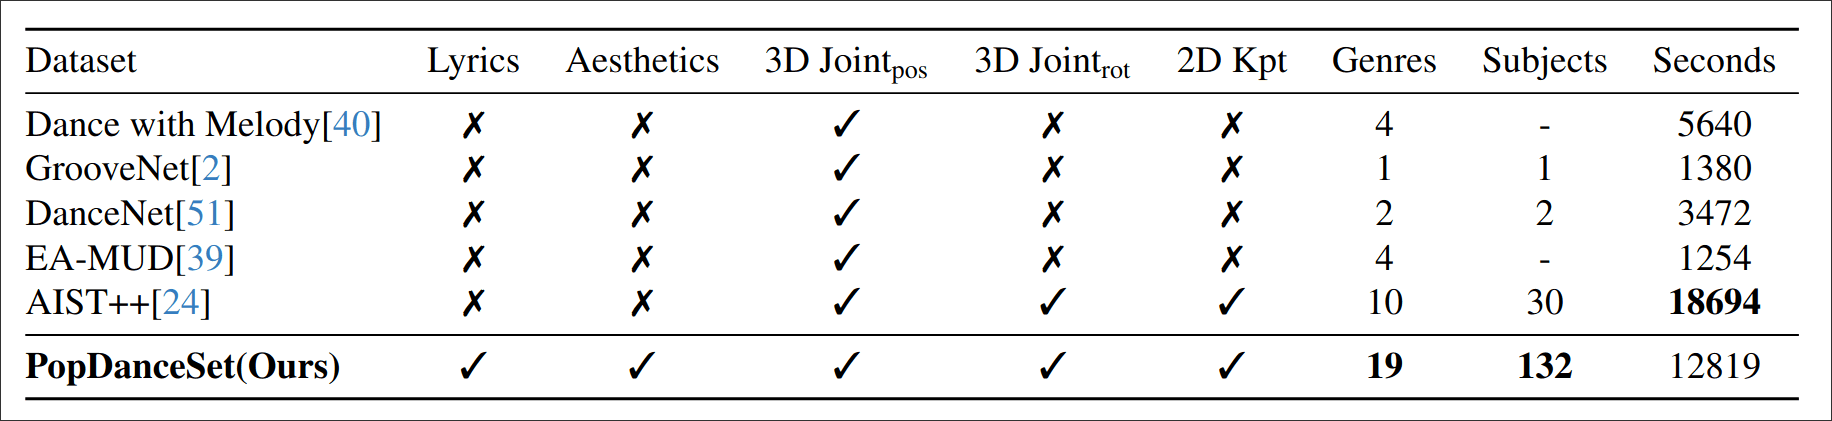
在看完aist++那篇论文后, 有了拆解骨骼的想法, 因为当我们做某个动作时, 我们说
双脚张开, 以脚踝为轴旋转50度, 腰跟随脚踝旋转, 然后双手张开, 微曲, 左手掌心向上, 右手掌心向下, 头偏向右手向前
注意到我们对脚, 手部, 头部, 腰部分别进行了表述, 最后表达了一个动作, 从该动作到下一个动作, 我相信也是可以以前一个动作为基础表示的
在讨论这种方式的好处时, aist++好像没有解释, 只是说消融效果更好, 而X-Dancer之所以分多部分主要是为了捕捉到更丰富的脸部和手部信息
其实在写这里的时候我已经读了好几篇论文, 我觉得X-Dancer是纯粹的diffusion框架, 它自己也说了它的目标是生成高保真, 具有生活气息的tiktok风格视频, 这类视频一旦达到一定的保真度就可以在短视频平台掀起一股潮流, 毕竟短视频只要吸引眼球就好
但是这类视频是经不起专业人士评价的, 在多项指标中表现并不好, 可控程度也有限, 但是我还是很看好这个方向, 我觉得作者将motion预测和图像生成分离开了, 这很好, transform就是擅长处理长距离依赖, diffusion在生成高保真图像上有天然的优势
作者不应该止步于"not exhibit the precision found in professional dancer videos", 这里是有很大改进空间的
- 它使用了二维motion, 可以获得更多的数据, 3D数据当然更好, 但是获取高精度大量数据太难了, 相反2D数据就好获取得多
- 在做这个任务前, 作者可以先尝试另一个领域, 我不清楚有没有人在做, 給一段舞蹈视频, 和另一个人的静态图片, 替换视频中跳舞的人, diffusion的输入一定要是提取到的motion, 一定要把这个任务的质量做到非常好在做music-dance任务
- transform, 根据music预测motion, 这个前面提到了一点, 其实具体怎么优化还没有太多想法, 再看点论文再评价
后续我会关注一下video->2D/3D motion的发展现状