VACE: All-in-One Video Creation and Editing
使用户能够在一体化框架中执行视频创作和编辑任务(参考图到视频生成, 视频到视频编辑以及遮罩视频到视频编辑).
Loading...
使用户能够在一体化框架中执行视频创作和编辑任务(参考图到视频生成, 视频到视频编辑以及遮罩视频到视频编辑).
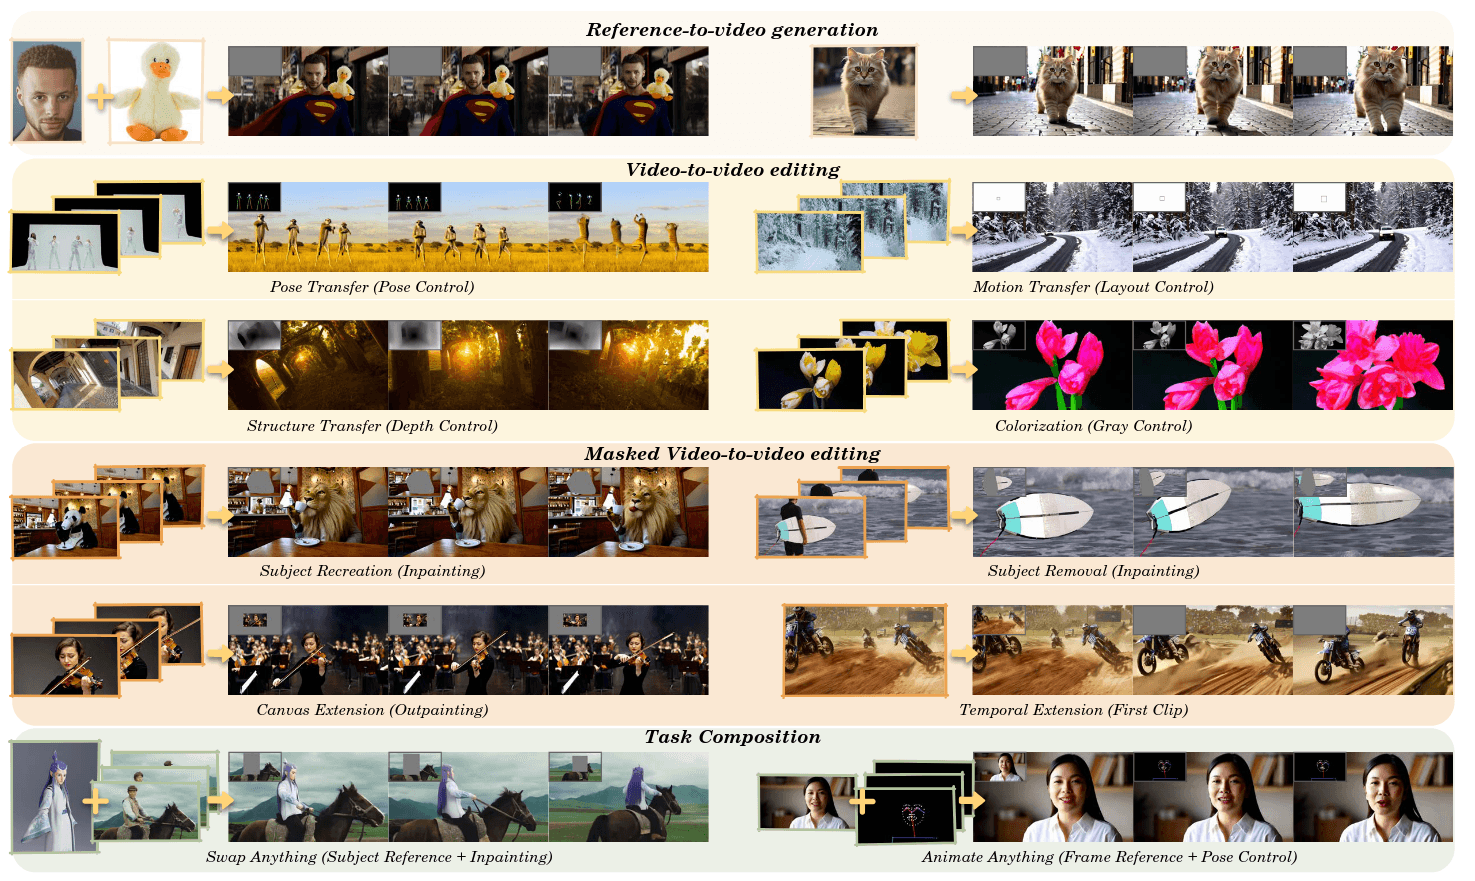
intro没什么好看的, 直接看method吧.
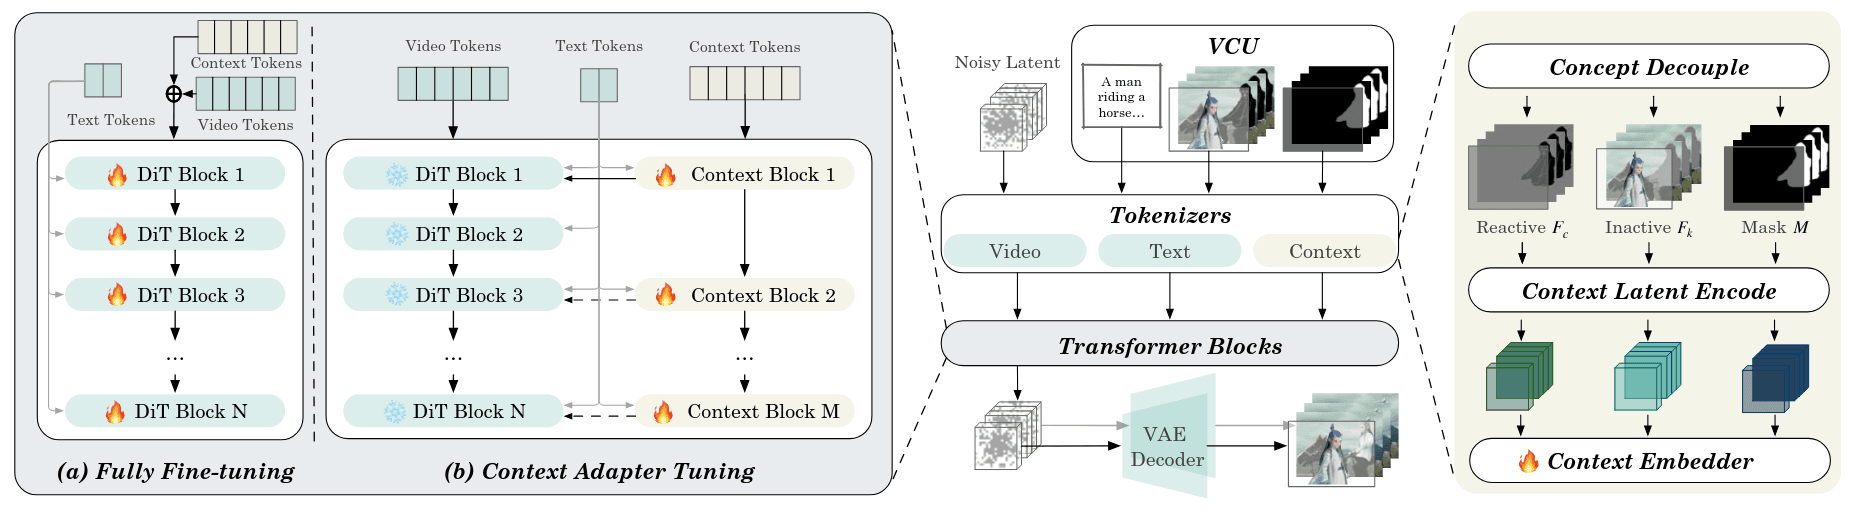
T, F, M分别代表 textual input, frame sequence(), and mask sequence(). u是RGB空间, 正则化到(-1, 1), m是二进制, 1表示编辑, 0表示不编辑. F和M在和n序列对齐.
Concept Decoupling. 基于掩码, 生成两个形状相同的帧序列: , , 其中为reactive frame, 为inreactive frame.
Context Latent Encoding. 参考图单独编码, 在时间维度做拼接.
Context Embedder. 在channel维度连接, 和 , 然后token化为context tokens, 称作Context Embedder. 其中和对应的权重矩阵从原视频复制, 的权重矩阵用0初始化.
介绍了两种方法, 第一种全量微调就不说了, 第二种controlNet的方法, 和ReferenceNet有点像, 复制原网络的若干层, 输入是context token, 将每一层的输出作为附加信号插入回DiT块中, 帮助主分支执行生成和编辑任务.
数据构建和benchmark. 核心就是设计了不同的任务, 怎么准备数据集的(像pose图通过dwpose提取), 把这些任务随机组合到一起, 进行训练. benchmark没什么好看的.