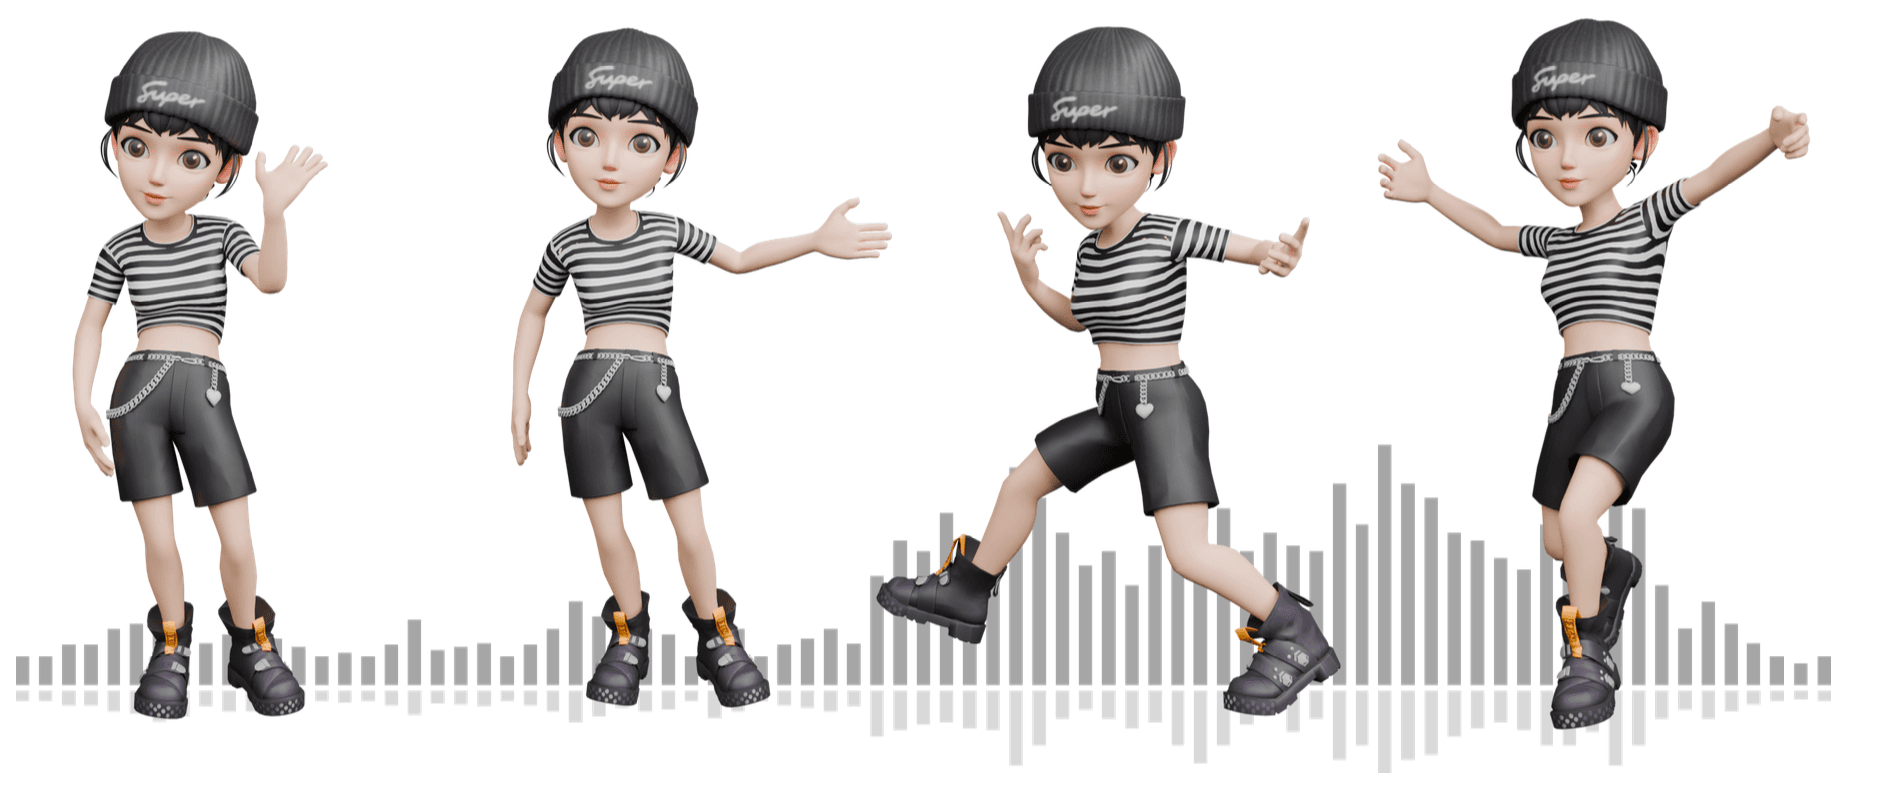EchoAvatar: Real-time Generative Avatar Animation from Audio Streams
语音或音乐驱动的动作生成,流式
Loading...
Audio-visual Controlled Video Diffusion with Masked Selective State Spaces Modeling for Natural Talking Head Generation
讲特点: 支持多信号控制的Talking head generation. 讲方法: 平行多分支, 门控机制, mamba structure保证时间和空间连续性, mask-drop策略.
FlowPortrait: Reinforcement Learning for Audio-Driven Portrait Video Generation
talking head generation任务, 使用了强化学习.