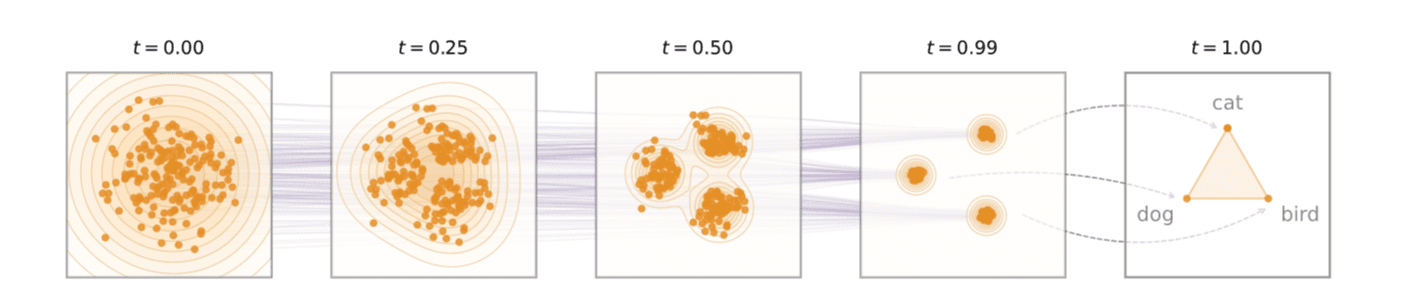
diffusion models和flow-based model成为生成连续数据的重要范式, 像图像, 视频和其它连续领域数据, 推动了运用到语言的兴趣(diffusion language models, DLMs).
DLMs以离散与连续两种方式表示, 连续DLMs将离散标记映射到连续表示, 并在连续空间中去噪, 离散DLMs在标记空间中操作, 在离散随机变量上构建概率扩散模型, 目前主要工作集中在离散领域, 尚不清楚连续DLMs的表现差距是由于语言建模本质上是离散的性质还是因为算法设计尚未被充分探索.
ELF是一种连续的DLMs方法, 基于Flow Matching. 两个特点: 1) 在连续空间中操作, 只在最后时间步考虑离散化; 2) 连续时间建模, 通过时间导数定义速度场, 让ELF能够受益于Flow Matching的进展.
ELF通过将编码器模型应用于输入的离散标记来构建连续的嵌入空间, 编码器可以是预训练, 联合训练或者随机权重冻结, 不需要解码器. 这种设计基于这样的观察: 流匹配中的最终时间步可以自然地重新用于将连续嵌入映射回离散标记, 从而消除了对显式解码器的需求.
ELF基于先前的连续LDMs, 但是几乎所有步骤在连续嵌入空间中进行去噪, 为Flow Matching提供了最大的灵活性.
Diffusion model和Flow-based模型通过ODE或SDE将噪声转换为数据, 在DDPM风格公式中, 生成由连续状态之间的转换定义, 这些状态可以是离散或连续的. 离散状态通过分类转换分布, 连续状态通过高斯噪声下的分数或噪声预测来建模. 流匹配通过学习沿连续路径的速度场将这一观点扩展到连续时间, 在这里噪声, 数据和速度预测可以相互重新参数化.
- 传统连续扩散模型尽管将 token 映射到了连续空间, 但通常在中间去噪步骤仍会引入 token 级别的监督或约束, 导致其生成轨迹仍受限于离散的 token 空间. ELF完全在连续的嵌入空间中进行去噪, 去除了中间步骤的 token 级监督, 仅在生成过程的最后一步才进行离散化.
- Latent Diffusion LMs多采用 DDPM 风格的噪声调度, 并且必须额外训练一个独立的解码器才能将潜在表示还原为文本. ELF采用了连续时间的流匹配架构, 由于只在最后一步进行离散化, 它可以重用同一个网络权重, 无需额外引入单独的解码器, 同时能直接享受流匹配技术在图像/视频生成领域的最新进展.
- 同期流匹配语言模型在连续的流轨迹上依然保留了 token 级别的交叉熵监督, 且为了实现少步快速生成, 往往需要依赖额外的"知识蒸馏"技术. ELF 将去噪轨迹完全保持在无限制的连续嵌入空间中, 不仅简化了模型, 而且无需任何蒸馏就能实现高质量的少步生成.
由于语言的离散性质, 另一条研究路线直接在标记空间中应用扩散. 主流为掩码扩散(在加噪阶段逐渐把 token 变成特殊的 [MASK] 标记, 在生成阶段则通过一步步"解掩码"来还原出具体的文本)和均匀状态扩散(不使用 [MASK], 而是将 token 逐渐打乱成概率均等的均匀分布, 这使得模型在生成时可以对生成的 token 进行反复的修改和推敲)
- 从离散到连续嵌入. 将输入的句子分解为离散 Token 序列, 然后将其映射到连续的嵌入空间. 嵌入方法灵活, 默认使用T5编码器获得双向上下文嵌入.
- 连续嵌入上的Flow Matching. 与标准流匹配预测速度不同, ELF直接预测干净的嵌入, 原因: 1) 使流匹配在 768 维等高维表示上依然有效, 2) 预测干净嵌入的目标与最后一步预测离散 Token 的目标在逻辑上是一致的, 便于去噪任务与解码任务共享网络权重. 训练损失: 通过最小化预测速度与目标速度之间的均方误差来训练模型.
- 回归离散 Token. 仅在生成过程的最后一步(t=1), 将预测出的干净嵌入转换回离散 Token, 不需要单独的解码器, 因为它将流匹配的最后一步视为自然的解码过程. 有数据增强, 引入bad input, 通过交叉熵随时来监督Token还原过程.
这一节就不看了, 感觉是因为method图, 因此用这种方式解释技术细节.
主要讲了如何控制 ELF 模型的生成内容, 并在生成质量与多样性之间取得平衡. 因为作者让文本嵌入变得连续, 可以大量借用图片和视频的工作.
- CFG. 很熟悉就不写了.
- Self-conditioning. 把自己初步预测结果, 作为下一步预测的条件. 这里就是视频领域一直在用的, 甚至还不到forcing.
- 训练时CFG. 图像生成领域的技术, 在训练阶段学习去拟合合并后的最终结果.
- 扩展到条件生成. 通过mask呗, 与传统transformer一样, 拼接到开头.
因为对这个领域了解就行了, 不需要专精就不看了, 没写训练成本.
感受
我觉得motion和text有共通点接近, 想着能不能借鉴一下思路. 暂时没想到...