PaperMiscellaneous
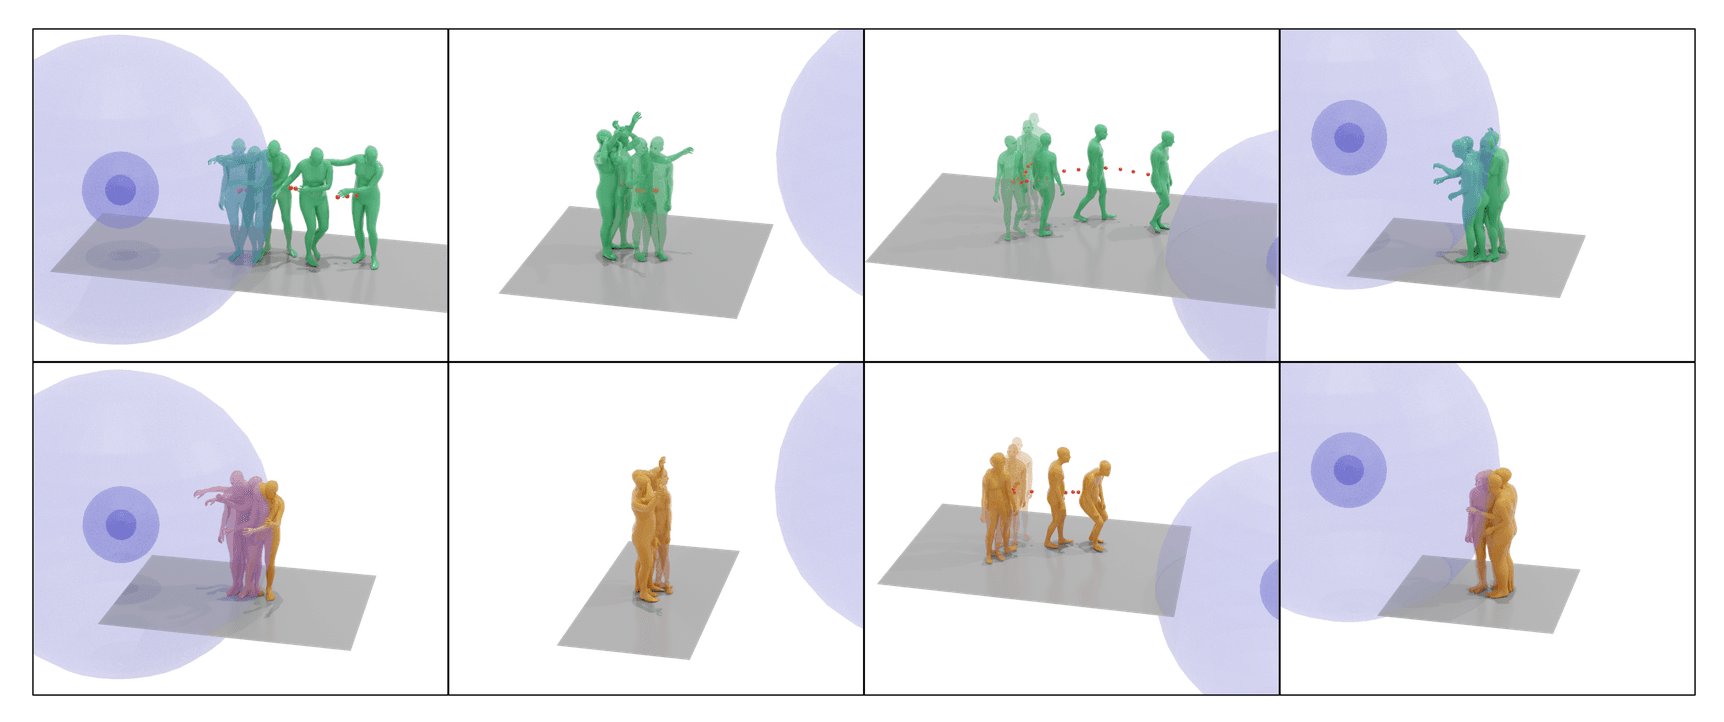
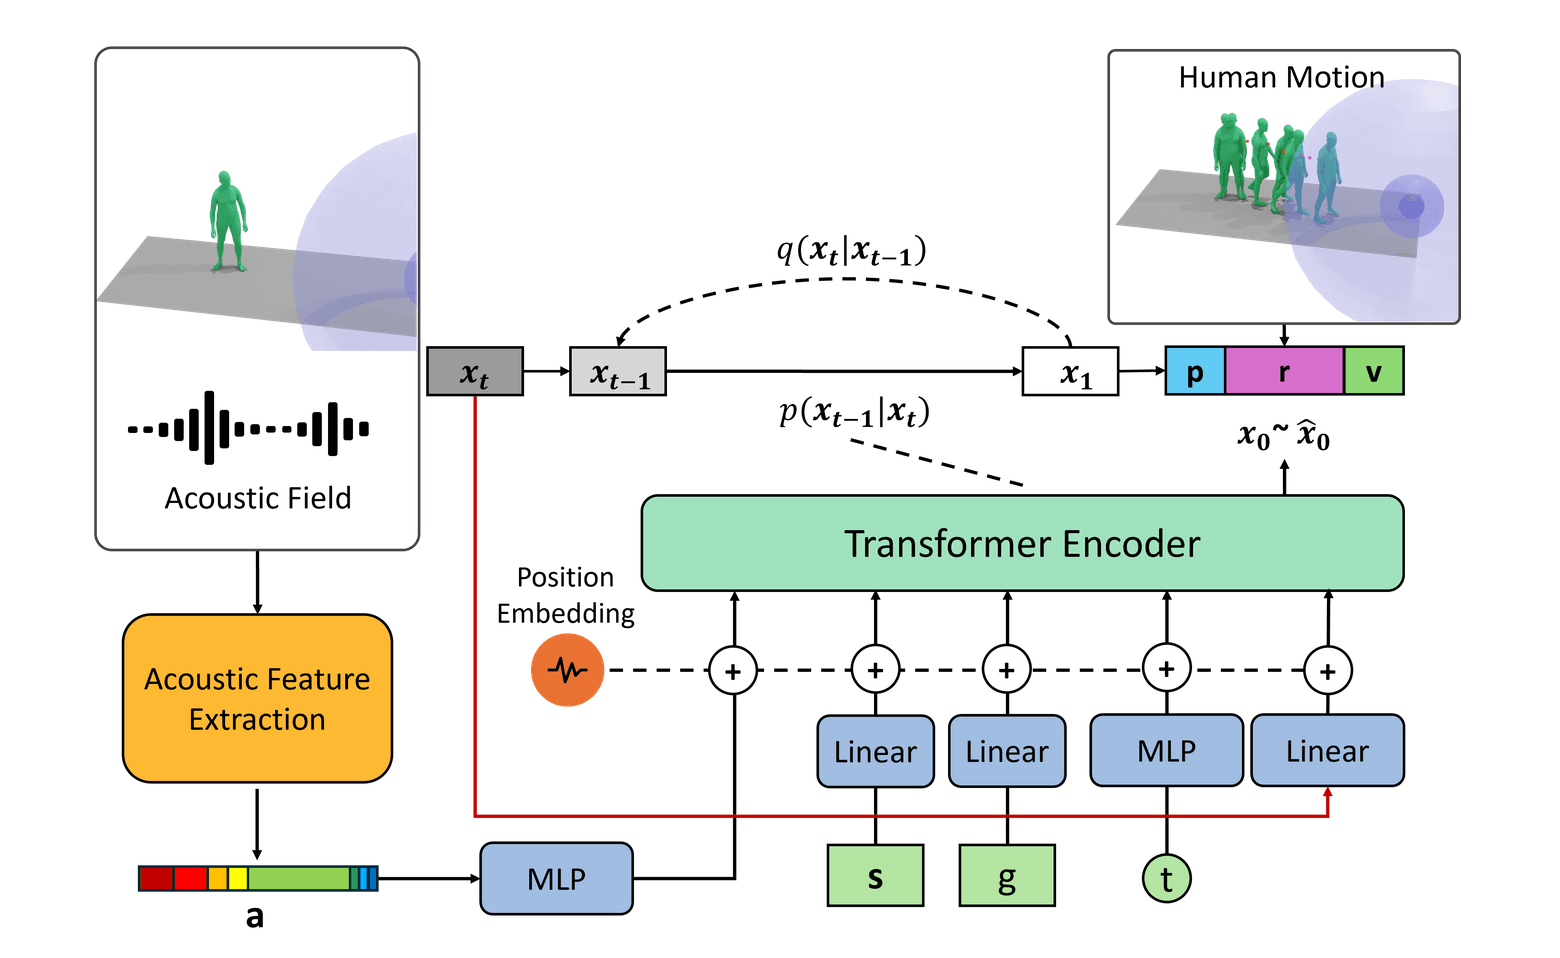
MOSPA: Human Motion Generation Driven by Spatial Audio
空间音频驱动的人体动作生成,提的新任务
Loading...
MMAudio: Taming Multimodal Joint Training for High-Quality Video-to-Audio Synthesis
给定视频和可选的text, 生成高质量同步的音频. 代替单一的video控制信号, 使用容易获取且长范围的audio-text数据集, 学习audio和语义对齐的样本. 条件同步模块实现视频和音频在帧级别对齐.
OmniForce: On Human-Centered, Large Model Empowered and Cloud-Edge Collaborative AutoML System
autoML旨在用最少的人力投入构建机器学习框架. 先前的工作很少关注在开放世界的良好工作, 一个解决方案是人机交互, 具有机器学习版本管理, 基于流水线的开发与部署, 灵活的搜索策略框架, 广泛提供并众包的应用算法(包括大模型)以及几分钟内提供远程服务这些特点, MaaS(Model as a Service)