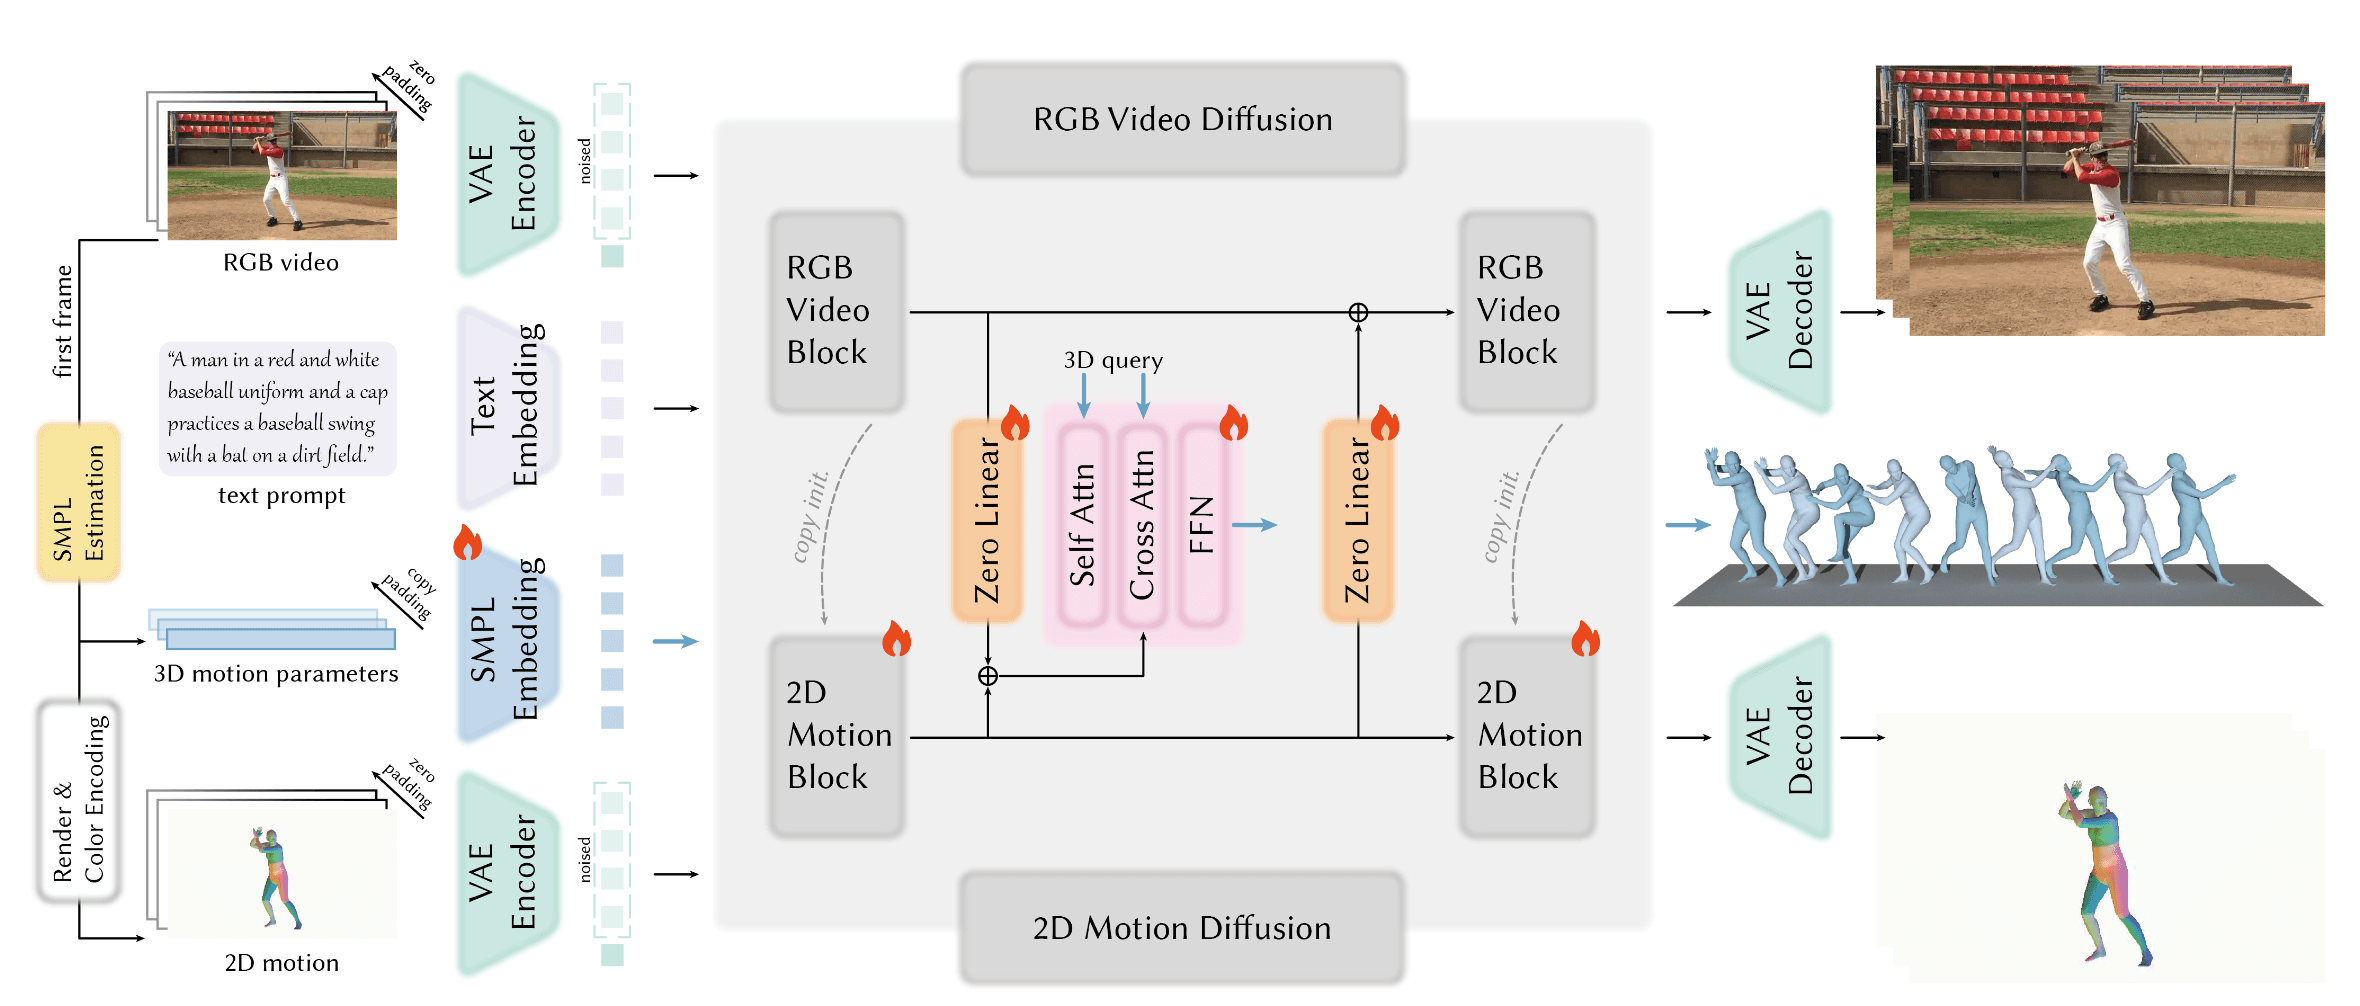
CoMoVi: Co-Generation of 3D Human Motions and Realistic Videos
文生动作任务,借助WM的能力,先生成视频再提取动作
Loading...
CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer
text-to-video的基础模型, 能生成10秒的长视频, fps为16, 分辨率768x1360. 卖点是长视频和文本连贯性. 3D-VAE, expert transformer, 分阶段多分辨率训练, effective pipeline. 结果在生成质量和予以对齐上都有所改进.
EchoMotion: Unified Human Video and Motion Generation via Dual-Modality Diffusion Transformer
现在是视频生成模型追求外观的保真度但是牺牲了基础的运动学原理学习, 无法生成人体复杂的动作. EchoMotion: 1)拓展了DiT到双分支结构支持不同的模态; 2) MVS-RoPE; 3) Motion-Video Two-Stage Training Strategy. 还提了个数据集HuMoVe, 80,000个视频-动作对