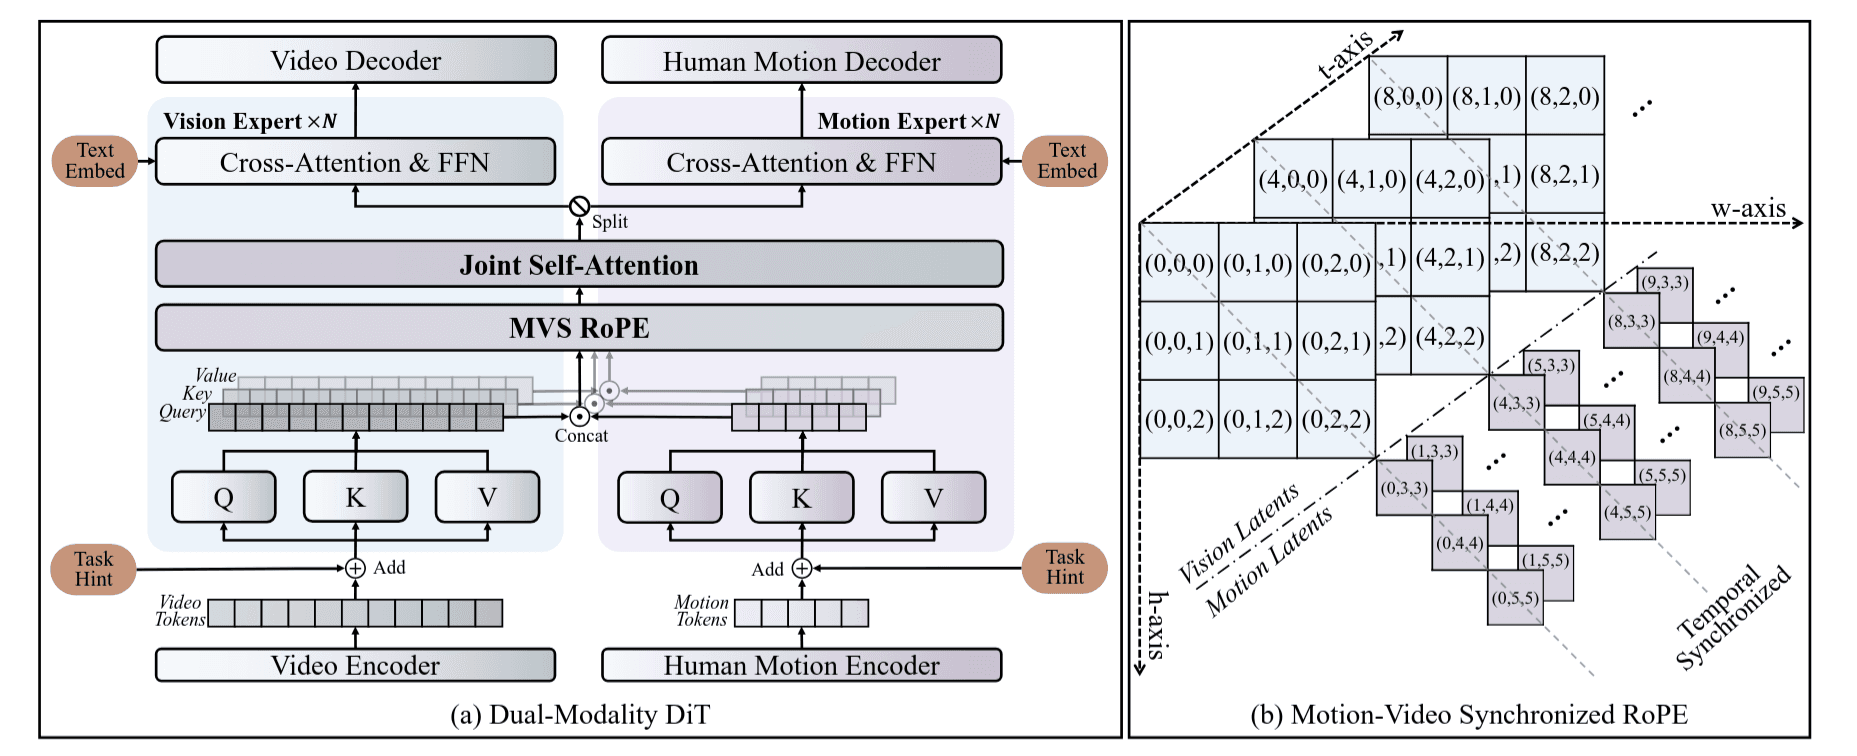
现有的MMDiT架构使用M-RoPE来统一处理文本和视觉模态,但它们没有考虑人体动作与视频之间的内在时间对齐关系。由于视频VAE通常有4倍的时间压缩,视频tokens和动作tokens的时间分辨率不同,需要专门设计位置编码来捕捉这种对应关系。
从method的右图可以看到MVS-RoPE的坐标系统设计:
空间维度:视频tokens占据基础的 (h,w) 区域(图中左下角的蓝色网格),而动作tokens被放置在"对角扩展"区域(图中右侧的斜向排列),通过偏移空间索引来区分模态。具体来说,第 i 个动作token的空间坐标是 (H+i,W+i)。
时间维度:视频tokens使用时间索引 t,而对应的动作tokens使用缩放后的索引 t/4,直接编码了4倍时间压缩的对应关系。
f^t,h,wv=R(t,h,w)⋅ft,h,wv
f^t,im=R(41t,H+i,W+i)⋅ft,im
其中 R(⋅) 是基于输入坐标的旋转位置编码函数。
- 保留预训练知识:视频tokens的位置编码与预训练时完全一致,不破坏已学习的表示
- 时间同步对齐:1/4缩放显式编码了多帧率关系,确保视频和动作在时间上完美同步
- 模态可区分性:对角扩展避免了"位置碰撞",模型可以轻松区分视频和动作tokens