Seaweed-7B: Cost-Effective Training of Video Generation Foundation Model
这是一篇科技报告, 字节跳动训练了一个视频生成基础模型Seaweed-7B. 1)性能与更大的模型媲美. 2)有广泛的下游应用
Loading...
这是一篇科技报告, 字节跳动训练了一个视频生成基础模型Seaweed-7B. 1)性能与更大的模型媲美. 2)有广泛的下游应用
基础模型在现代机器学习中至关重要, 视频生成的进步可以推动图片动画化, 视频编辑, 视频动画化等一系列下游应用的进步.
视频生成最近几年高速发展, 训练视频生成基础模型需要大量GPU算力.
视频生成推理比语言和音频占用更多GPU内存, 更多服务器开销, 主流倾向于使用中小型模型.
在大语言模型领域, Deepseek v3(37B)超过了72B和420B的稠密模型, 关键是Moe, MTP和高质量的数据集.
在视频生成领域, 小模型和大模型之间还有很大差距, Seaweed-7B讨论了一种具有成本效益的方式训练视频生成基础模型. 1000块H100上训练了27.7天, 共665,000小时.
在评估阶段, 讨论了通用生成能力和下游泛化能力. 结果表明中型网络还有很大的开发潜能.
数据的质量和多样性比数量重要. 数据量是100M条, 长度都是8s左右.
有一个复杂的数据处理管道: 时间分割, 空间裁剪, 质量过滤, 多方面数据平衡, 视频去重, 视频caption, 系统提示词. 每一类也都有详细介绍.
分割, 裁剪, 筛选, 去重, pack管道处理. 提到了两个工具BMF和Ray.
介绍了一下VAE的概念, 压缩率的计算, 特别关注输入是picture+video, picture应该是视频首帧. 接着它们写了实验的几个发现.
从低分辨率的图片开始, 使文本提示词和寻常的视觉概念可以对齐. 接着在每个batch, 图片和视频的token以一定的比例混合, 完整的配置见下表.
| Training stage | Image Resolution | Video Resolution | Step Percentage |
|---|---|---|---|
| Stage 0: 256p | [256×256, 512×512] | - | 37.5% |
| Stage 1: 256p | [256×256, 512×512] | [256×256] | 25.0% |
| Stage 2: 480p | [640×480, 1280×720] | [640×480] | 25.0% |
| Stage 3: 720p | [1280×720, 1920×1024] | [1280×720] | 12.5% |
在视频训练过程中, 包含text-to-video, image-to-video和video-to-video任务.
text-to-video任务最难收敛, 我们发现小比例(20%)的image-to-video任务改善text-to-video的表现, 但是比例太大就适得其反.
介绍了两种方法, 1)supervised fine-tuning (SFT), 这个主要是为了改善美学和视觉风格, 他们提取了700k个质量很高的视频进行训练, 然后又这里面又精选50k个视频个最高的权重, 定学习率的情况下训练, 训练需适度, 延长训练很容易导致prompt-following和motion质量的下降. 2)reinforcement learning from human feedback (RLHF), SFT以后经常发现motion和结构不一致的问题如下图, 通过Direct Preference Optimization (DPO), 它们要求从生成的4个视频中选择最好的和最差的, 用于改善训练.
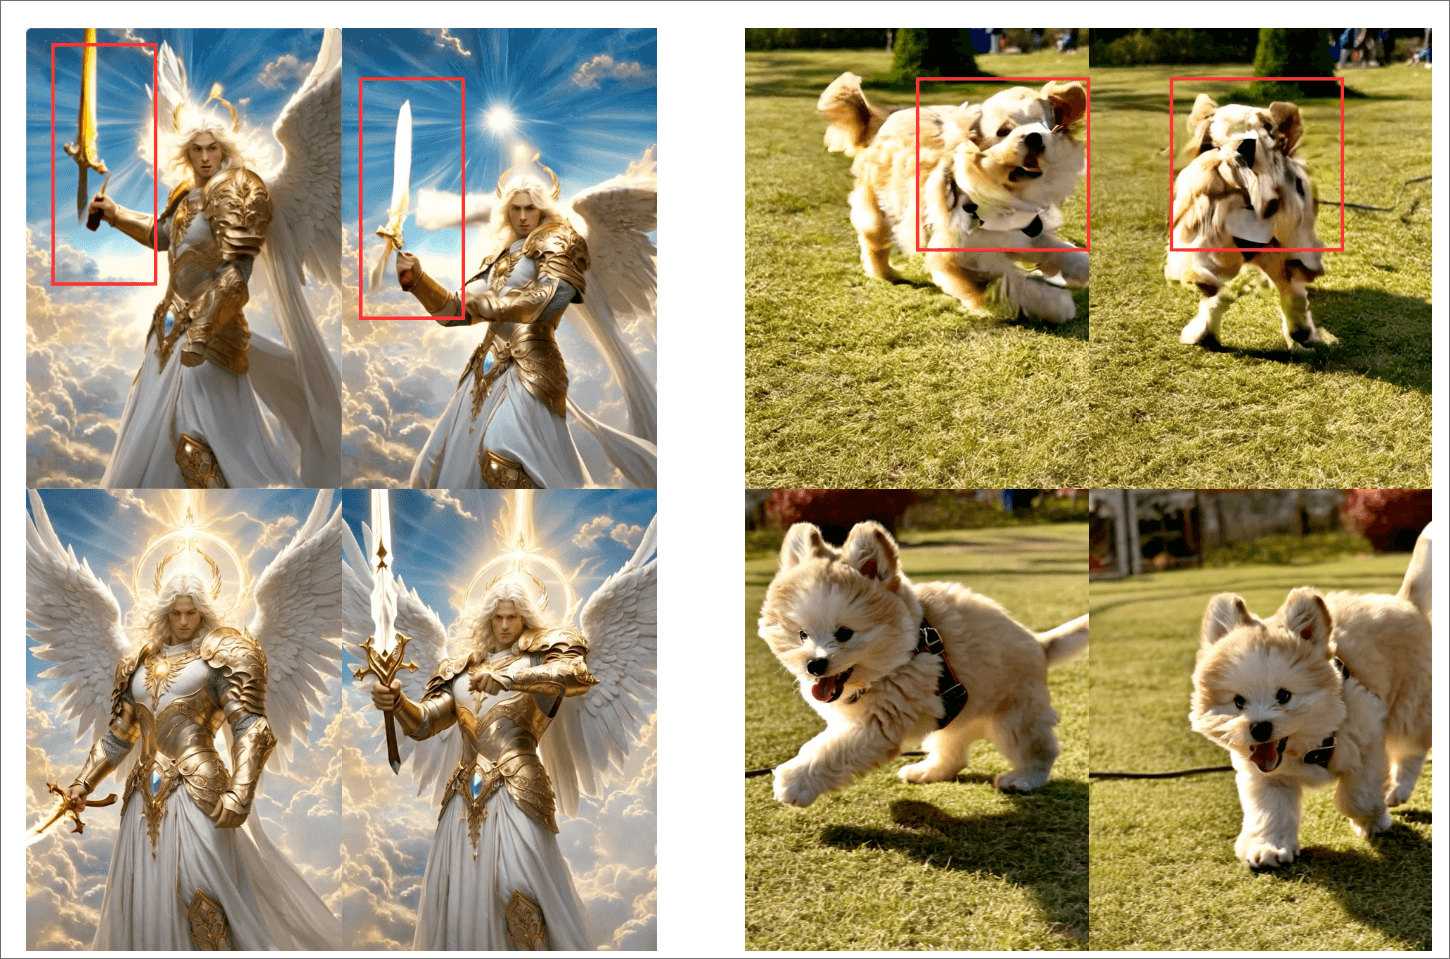
没有必要转换参考模型. 其实就是说偏好数据集在参考模型上训练一轮就够了, 多训练提升不大还会导致其他维度的表现下降. 对image-to-video任务的特别处理. 它的大致意思是生成视频的首帧和后面的不对齐, 当前的loss无法指导, 然后它们怎么做的没有看懂.
3D平行策略. 1) 数据并行, 一个batch分成很多小份, 每个GPU处理一小份. 2)模型分片. 使用FSDP (Fully Sharded Data Parallel)将模型参数, 优化器状态和梯度分配到不同的GPU上. 3)上下文并行. 使用Ulysses技术迭代的将样本在序列维度(文本长度方向)和头维度(多头注意力维度)上进行分片.
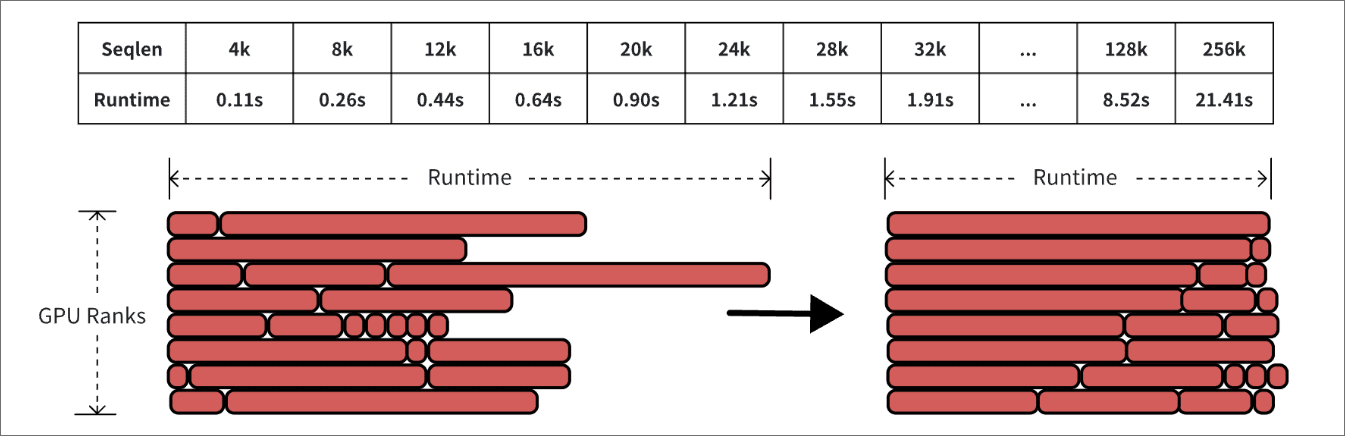
runtime平衡. seq长度和runtime之间并不是线性关系, 也就说相同seq长度的数据组合在同一片GPU上的runtime可能是不同的, 实验统计了不同seq的runtime, 优化了分配策略. 见下图
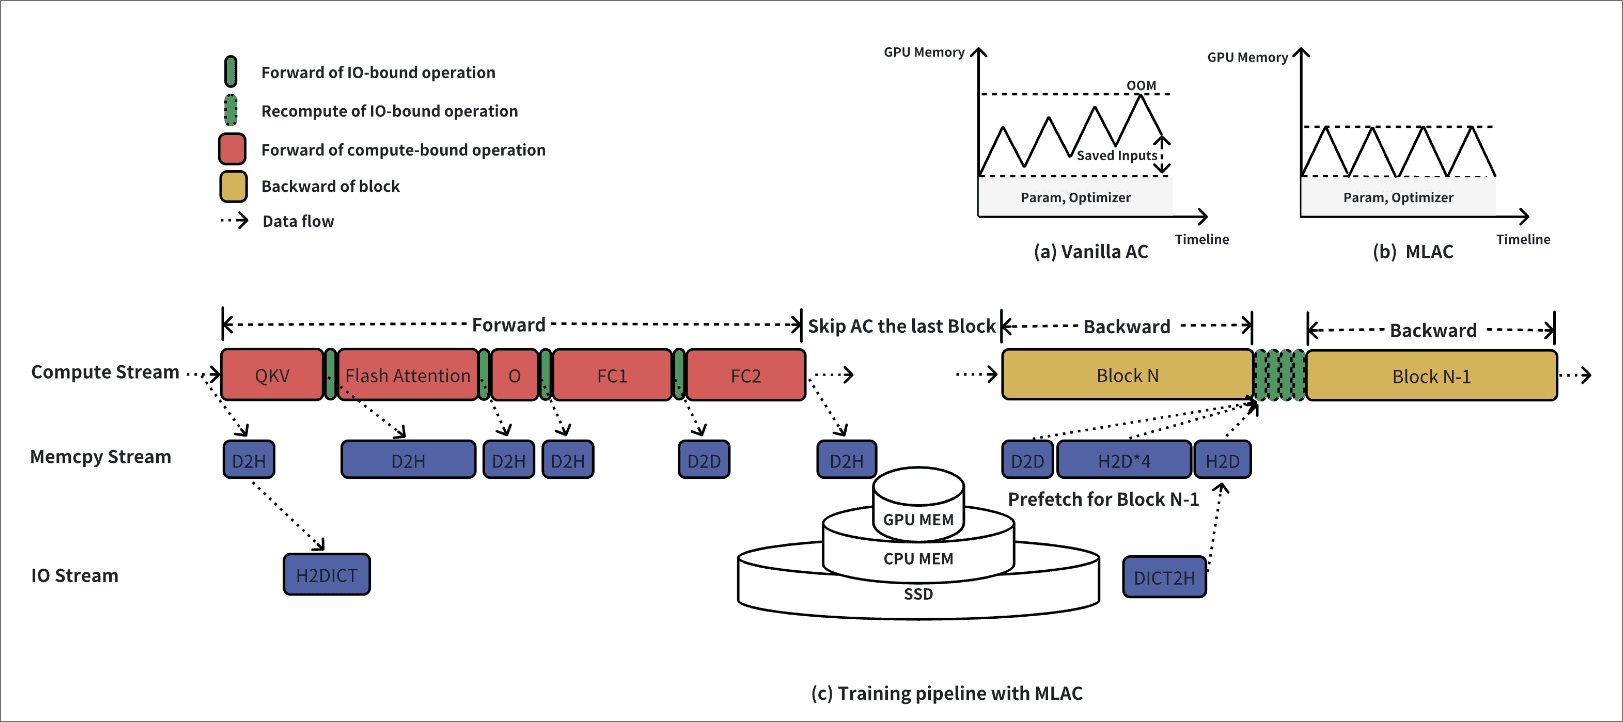
不是重点, GPT速通一下
选择了image-to-video任务和text-to-video任务.
它们在一个网站进行真实用户的评估(cool), 相应指标是Elo scores. 另外他们还额外提出了视觉质量, motion质量, prompt following, 参考图像连续性这些指标.
和wan2.1对比, 质量更好, 速度快了62倍.
反正就是一些指标,,,
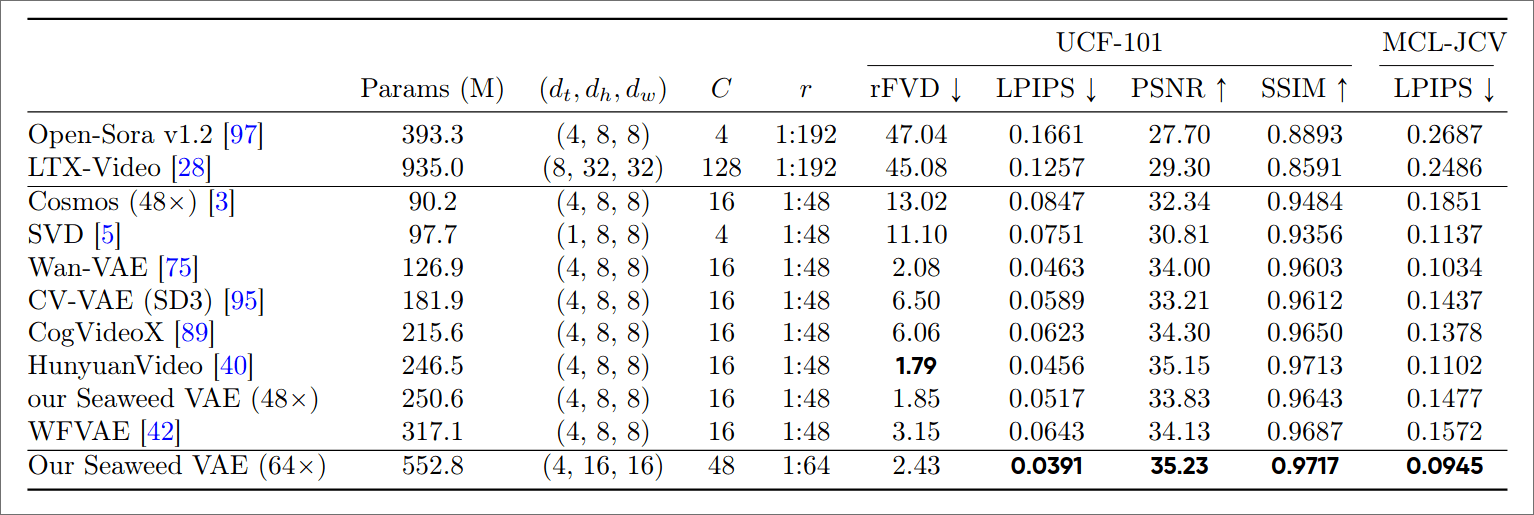
image-to-video, human video, subject-consistent, video-audio joint, Long-video generation and storytelling, Real-time generation, Super-resolution generation, Camera controlled generation
详细的笔记确实可以提高阅读的质量, 论文的内容经过自己的思考后重新表述一遍也不能说是浪费时间, 不断否定自己是真的痛苦, 先这样尝试一段时间, 希望读熟练了可以做到详略有当.