Causal World Modeling for Robot Control
Loading...
(文章写的挺有意思的,intro和method结合很紧密,在intro说VLA局限,当前WAM局限,然后在method通过和这些方法对比说明自己的范式,很像中文论文的写作思路)
先是指出了VLA的底层挑战(表征纠缠),就是要单神经网络学习视觉场景理解,物理运动学和运动控制,信息过度压缩和纠缠。
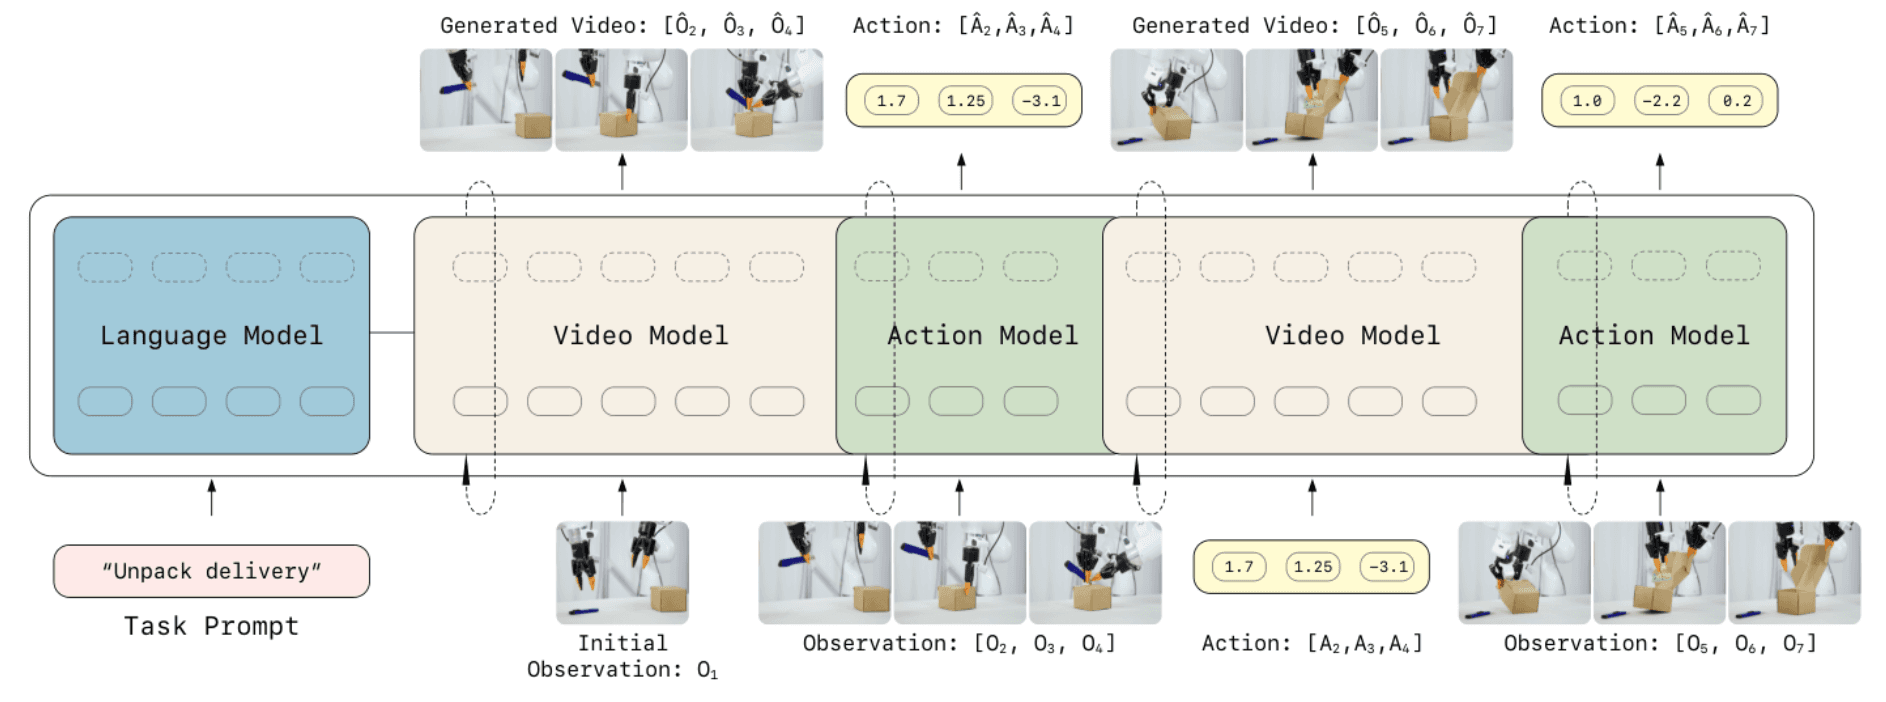
模型主框架采用的是Motubrain的双流范式,但是动作Block的d更小。
视频信息和动作信息是怎么沟通的?
- 分开投影:各自计算 Q、K、V
- 视频 Token:使用的是视频生成主干网络(Wan2.2-5B)原有的 QKV 投影矩阵来计算自己的 Q、K、V。
- 动作 Token:使用的是动作流专门新增的 QKV 投影矩阵来计算自己的 Q、K、V(为了让训练更稳定,这些新增的动作矩阵权重是从视频网络的权重里插值初始化过来的)。
- 维度对齐与合并计算
信息沟通发生在视频流的self-attn,把动作 Token 的维度通过一个线性层拉伸到与视频 Token 一致后,直接把动作的 QKV 拼接到视频的 QKV 序列中。
在拼接 Q、K、V 时,视频 Token 和动作 Token 是严格按照时间交错排列的,
[第 t 帧视频] -> [第 t 时刻动作1] -> ... -> [第 t 时刻动作τ] -> [第 t+1 帧视频] -> ...MASK掩码机制的实现也是在这里,视频不看动作只看之前的视频,动作看之前的动作和视频。
- 分离与还原:各回各的特征流
在同一个注意力池子里完成信息交换后,两类 Token 需要“分道扬镳”:
- 视频 Token:带着融合了动作的新信息,继续往下走视频网络原本的前馈神经网络(FFN)等后续结构。
- 动作 Token:带着融合了画面的新信息,通过一个残差连接(Residual connection)重新投影回它自己原本较小的维度(d_),继续走动作流自己后续的网络结构()。
最后说一些实际部署的trick:视频特征不需要完全去噪,KV-Cache机制预测新时间步时不需要全部KV全部重算