Cosmos 3: Omnimodal World Models for Physical AI
Loading...
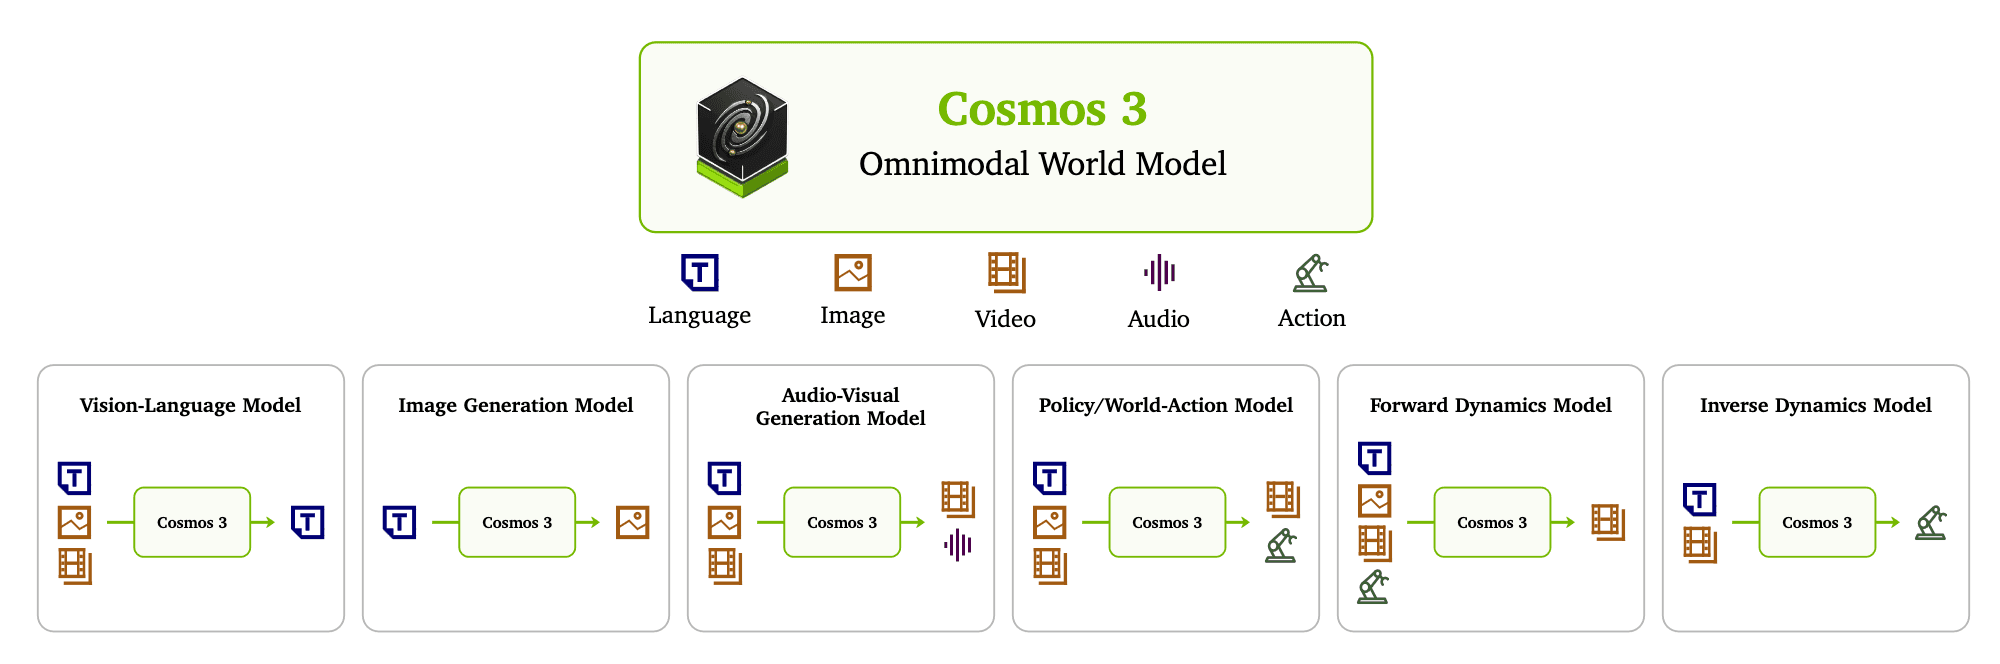
不同的模态使用不同的编码器,然后通过MLP映射到统一维度。为了区分不同模态,在将非语言模态的 token 送入 MoT 主干网络之前,加上一个可学习的、特定于该模态的嵌入向量。
AR子序列解释普通的VLM模型(因果),扩散子序列负责生成图片,视频,音频和动作(双向),通过拼接KV值进行交流,DM可见AR,AR不可见DM,然后为了处理不同帧率的视频用了FPS 调制
总结,其实可以分两段看,AR先观察视频或者图片形成对当前环境的理解,然后DM负责生成,又因为一些原因DM和AR都是用了VLM模型初始化(AR训好了之后给DM初始化)
其它需要关注的信息有prompt是用json结构化标注;训练也使用了多分辨率分阶段,中期训练才引入动作数据(认知是为现有视频生成模型增加动作模态不会很困难),然后有对特定任务的微调;为异构动作数据统一了几何表示;文本、图像和视频的 Token 数量差异巨大,开发了基于 Token 预算的序列打包和双向扁平注意力算子,使得混合模态数据能在不添加无意义填充的情况下高效填满 GPU 内存,显著提升了训练吞吐量。
为什么DM子序列要用VLM(qwen3-VL)初始化,在我看来用视频生成模型像wan2.2初始化不是更好吗?
这是一个非常合理的疑问。直觉上,既然扩散(DM)子序列负责生成视频,用一个现成的优秀视频生成模型(比如 Wan 2.2 的主干网络)来初始化似乎是最对口的。
但在 Cosmos 3 的设计中,研究团队不仅使用了视觉语言模型(VLM,如 Qwen3-VL)作为基础,而且具体的流程是:先用 VLM 训练好推理器(Reasoner),然后直接用训练好的 Reasoner 的权重来初始化生成器(Generator,即 DM 子序列)。
之所以不使用纯视频生成模型的主干网络来初始化,主要是出于以下几个核心原因:
- 注入深度语义与“世界知识” (Transferring Semantic and World Knowledge) 物理 AI 所需的视频生成,不仅仅是让像素动起来,而是要严格遵循物理规律、因果关系和复杂的文本指令。纯视频生成模型在“画质”和“动态”上很强,但缺乏大语言模型那种深刻的逻辑推理能力。 通过使用训练好的 Reasoner 权重来初始化生成器,模型能够将强大的语义理解和世界知识直接转移到一个能够合成像素、音频和动作的模型中()。这使得 Cosmos 3 在学习生成高保真视频的同时,直接继承了 VLM 强大的语言和视觉推理能力()。
- 混合架构的对称性与空间对齐 (Architectural Consistency) Cosmos 3 采用的是混合 Transformer (MoT) 架构,在这个设计中,推理器(AR)和生成器(DM)共享同一个 Transformer Block 架构()。 在生成过程中,DM 序列的 Token 需要通过双向注意力机制去关注 AR 序列中的 Token(如文本提示或输入图像)()。如果生成器使用 Wan2.2 这样的外部视频模型权重,其参数空间、注意力维度与基于 VLM 的 AR 序列完全不匹配。使用相同的 VLM 权重来初始化这两条路径,保证了它们在底层的特征维度是天生对齐的,极大地降低了联合注意力的学习难度。
- Wan 2.2 并非完全缺席,而是被用在了“刀刃”上 值得注意的是,Cosmos 3 并没有完全抛弃 Wan 2.2。对于用于生成的视觉特征,Cosmos 3 直接采用了 Wan2.2-TI2V-5B 的视频 VAE 编码器()。 这意味着,模型将“如何把视频压缩成高质量的连续特征”交给了专业的 Wan 2.2 VAE 编码器处理(在训练期间保持冻结)(),而将“如何根据文本和逻辑去预测未来帧”交给了拥有 VLM 大脑的混合 Transformer 主干网络()。
简而言之,不用视频生成模型初始化 DM 子序列,是因为物理世界模型需要一个“懂物理逻辑和复杂语义”的大脑(VLM),而不是一个纯粹的“视频渲染引擎”。