Cosmos Policy: Fine-Tuning Video Models for Visuomotor Control and Planning
Loading...
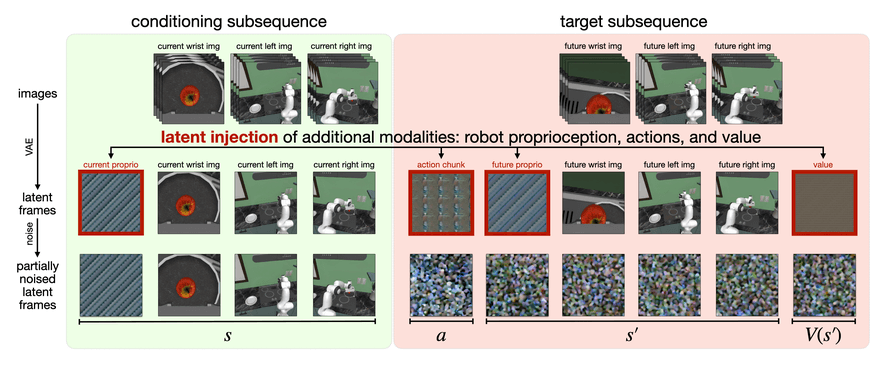
核心思想是把动作看成图片帧,正常视频生成模型的一个长视频latent序列可能是:
当前【三视角图像特征】--->未来【三视角图像特征】
它把动作表示和vaule表示都伪造成了图像latent
当前【proprioception】--->当前【三视角图像特征】--->未来【action】--->未来【proprioception】--->未来【三视角图像特征】--->【价值函数】
看起来有点像插帧,但是这里面是有trick的,因为VAE压缩有损,插帧发生在过VAE之后,因为VAE对时间维度进行了压缩(1+T ---> 1+T/4),作者的做法是对1用全黑图片,对原视频每一帧复制4份,用4张全黑图片占位后面要换成【action】的位置
动作是怎么编码成图像latent的
动作就是一串数字,因此其实可以换一种表示,就是怎么把数字编码的与图像latent相似。
- 归一化: 将真实的动作矩阵 K \times d_{act 的每一维数据,缩放到 的范围内()。
- 展平(Flattening): 把归一化后的动作矩阵,拉平成一个一维的向量(长度为 K \times d_{act)。
- 复制填充: 计算出这个大空间能装下多少个动作向量(即计算 的倍数),然后把这个一维动作向量复制,直到它的元素数量刚好等于隐空间帧的容量()。
- 重塑与覆盖: 把复制好的、庞大的一维数组,重新Reshape成 的三维形状()。然后,用这个充满了动作数据的张量,直接覆盖掉原占位latent。
vaule就是一个0到1的数字,编码成图像latent的方式与action一致,注意在推理的时候,模型会取这N份复制的平均作为action的输出。
proprioception和action的区别
在数据表现形式上,它们都是一组代表关节角度的数字,但是Proprioception是一种观测值,它代表的是机器人此时此刻客观存在的物理状态,Action是一种控制指令,它代表的是模型下达给电机去执行的目标或驱动力。Proprioception 属于过去或现在,Action 指向未来。由于存在物理延迟,惯性,阻力和意外,论文中分开表示了。
Vaule到底是什么
可以当成一个成功率预测器,“如果机器人处于某个特定的状态,它最终成功完成任务的概率”
在训练时,其实有两类任务,一类是最终失败的任务,一类是最终成功的任务。如果是成功的轨迹,越靠近最终成功的步骤,分数越接近 1(乘以一个衰减因子 );如果是失败的轨迹,整个轨迹的价值就都是 0(或非常低)。
这个预测器在推理时有用,Best-of-N选择最优的候选动作