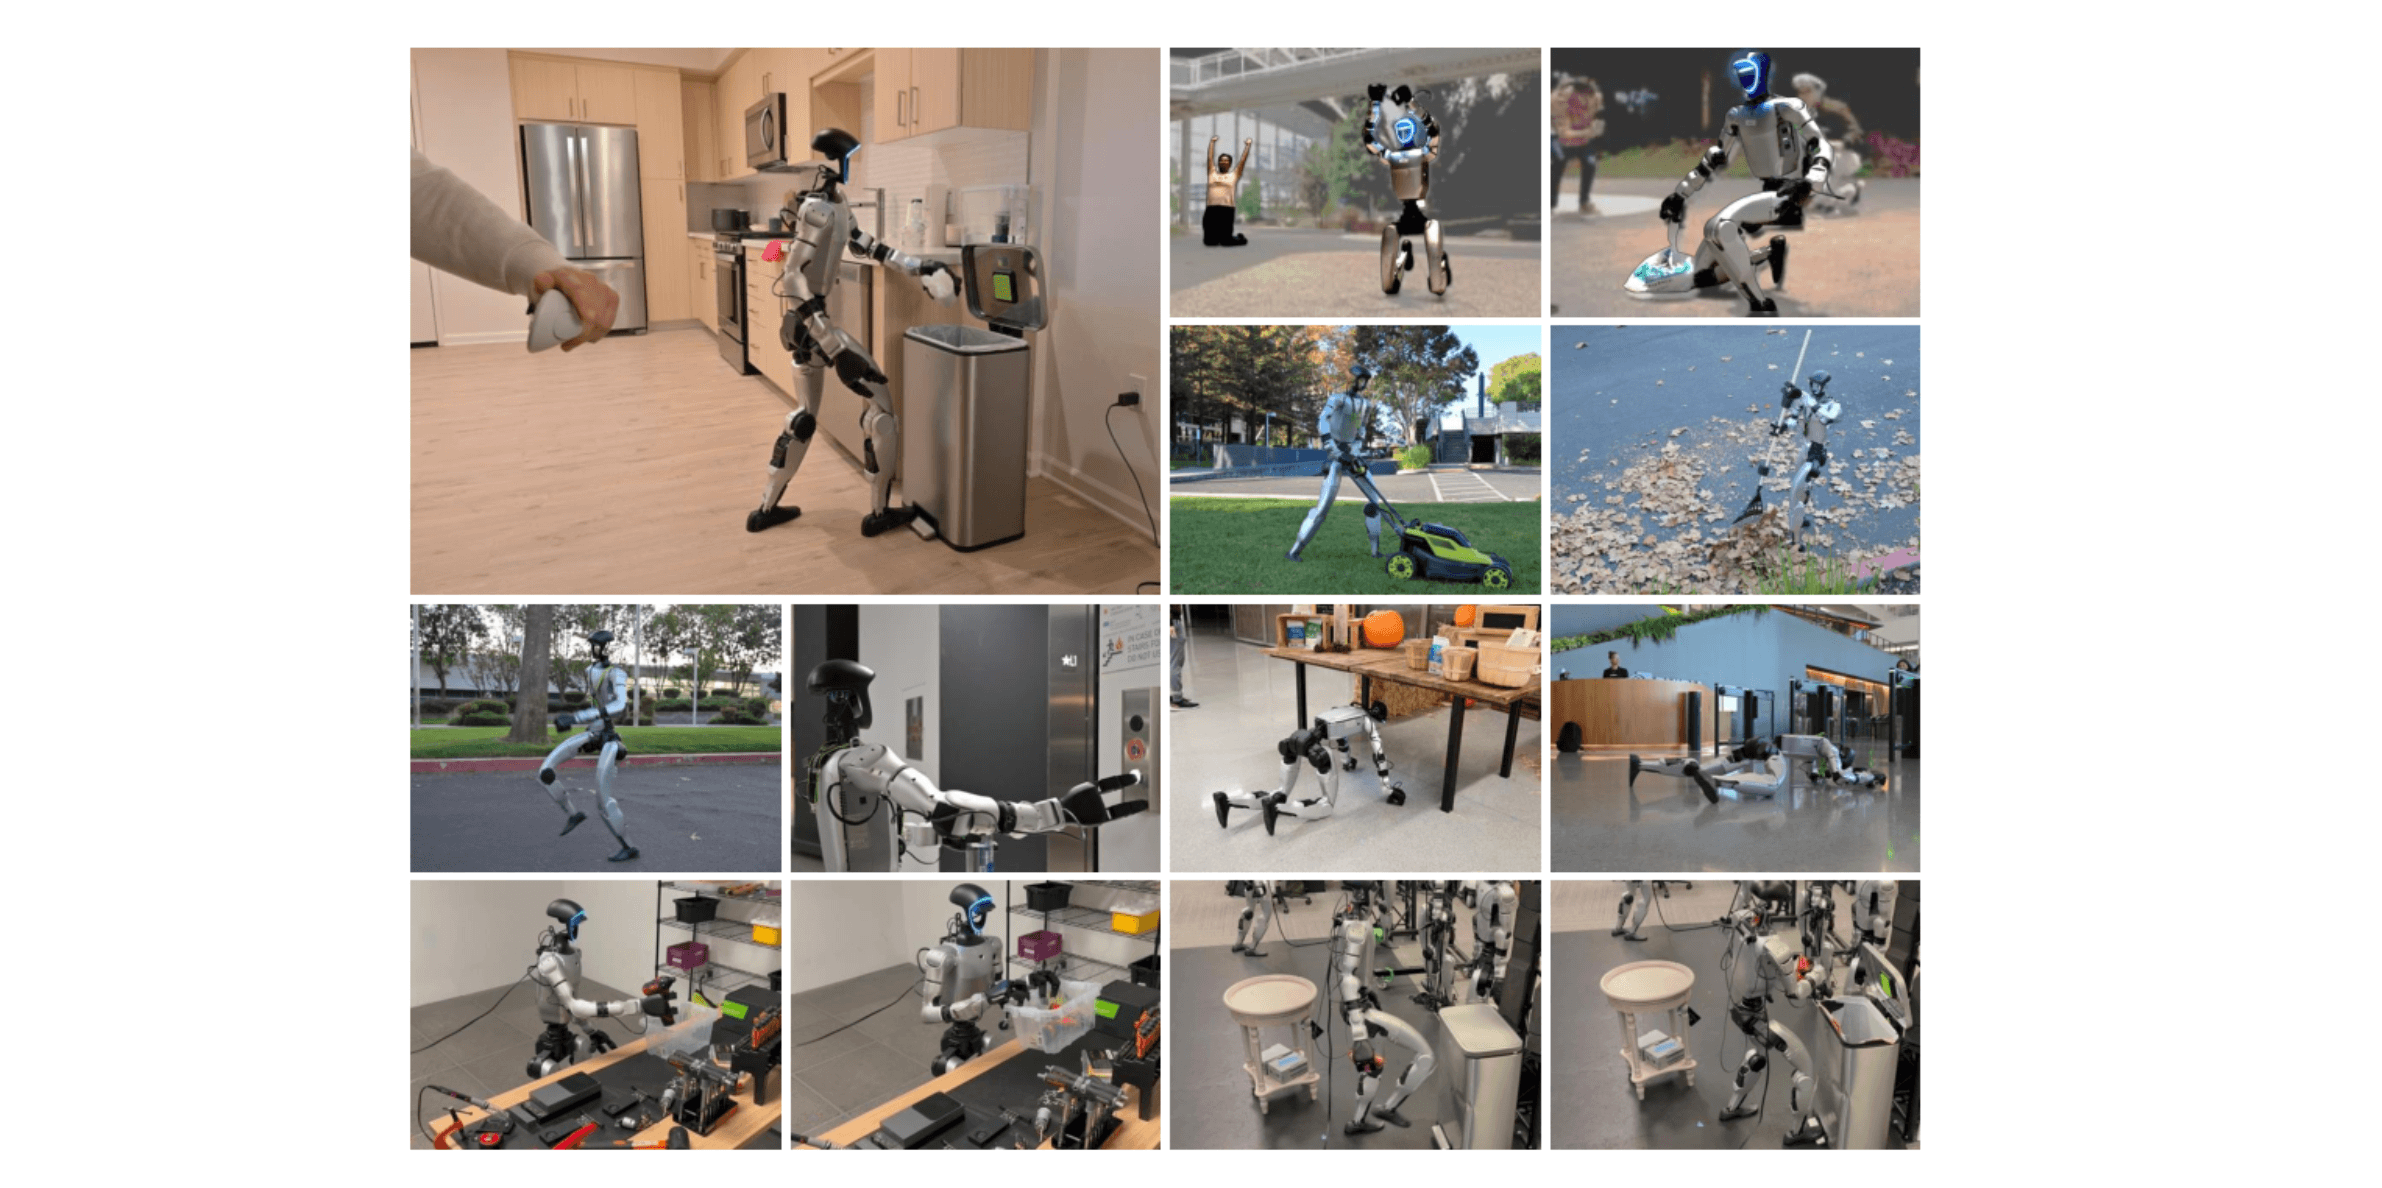
难点在于找到一个统一、可扩展的学习目标,使一个 policy 能够从大规模、多样化的人类动作数据中学习(追踪motion);将不同形式的任务/控制信号,统一接到同一个 humanoid controller 上。其实在讲同一件事情,就是不同的任务,使用motion进行统一监督,然后用一个通用的motion表示方式去统一机器人,真人和混合动作
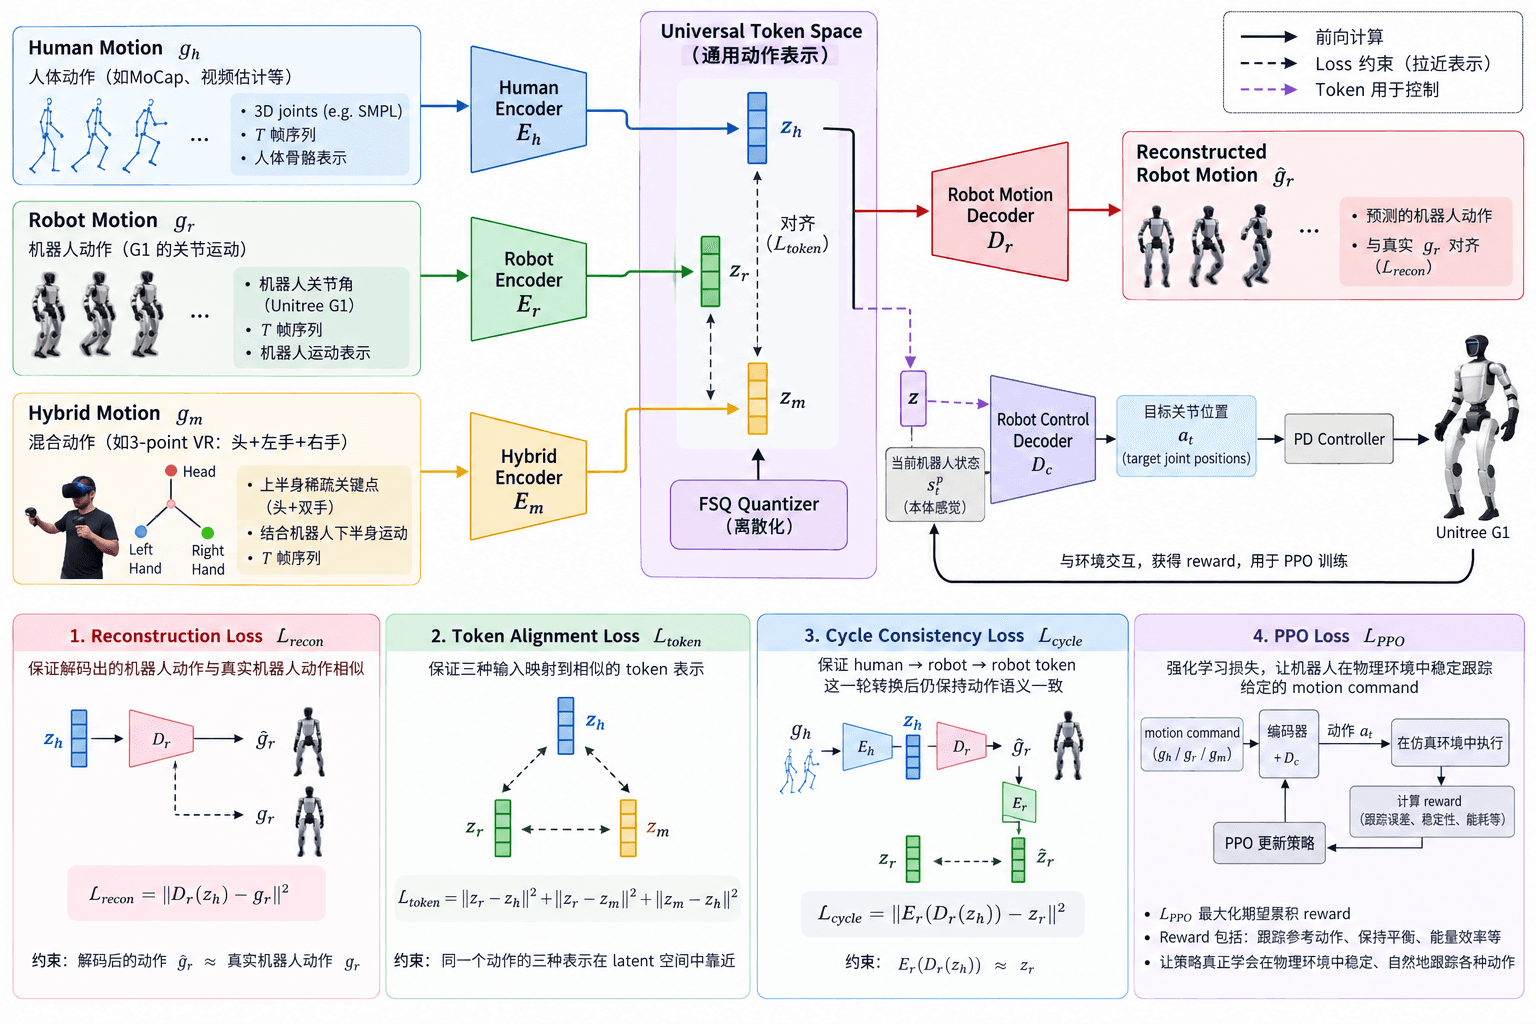
这里重点解释一下混合动作(Hybrid Motion),例如3-point VR teleoperation,操作者戴着 VR 设备,通过头 + 左手 + 右手三个追踪点来控制机器人全身动作
Universal Motion Representation
首先只考虑 Robot Motion 这一条路线。给定机器人动作 gr ,SONIC 使用 Robot Encoder Er 将机器人动作编码到 latent space,得到对应的 token zr,然后再通过 Robot Motion Decoder Dr 将其还原为机器人动作g^r:
gr→Er→zr→Dr→g^r
这一过程可以理解为一个基本的编码---解码过程:Er将高维的机器人动作压缩到一个更加紧凑的向量空间,而 Dr则负责从这个空间中恢复机器人动作。但 SONIC 并不希望这个 latent space 只能表示 Robot Motion,而是希望Human Motion、Robot Motion 和 Hybrid Motion都能够映射到同一个通用动作表示空间。
因此,作者分别设计了 Human Encoder Eh、Robot Encoder Er 和 Hybrid Encoder Em:
gh→Eh→zh
gr→Er→zr
gm→Em→zm
对于同一个动作,虽然 gh、gr 和 gm使用不同的形式描述,但是它们表达的运动语义应该是一致的。因此,理想情况下,希望三种encoder 得到的 token 尽可能接近:
zh≈zr≈zm
为此,作者引入了 Token Alignment Loss:
Ltoken=∥zr−zh∥2+∥zr−zm∥2+∥zm−zh∥2
Ltoken 直接约束三种 motion representation 编码得到的 token,使同一个动作的 Human、Robot 和 Hybrid 表示能够映射到相近的位置,从而构建统一的 Universal Token Space。但是,仅仅保证 token 相似还不够。既然 zr 和 zh 与 zm 表达的是同一个动作,那么它们经过同一个 Robot Motion Decoder Dr 后,也应该能够恢复出对应的机器人动作 gr。
因此作者进一步引入 Reconstruction Loss:
Lrecon=∥Dr(zr)−gr∥2+∥Dr(zh)−gr∥2+∥Dr(zm)−gr∥2
其中 Human Motion 这条路线尤其值得关注:
gh→Eh→zh→Dr→g^r
它实际上完成了一次从 Human Motion 到 Robot Motion的转换。因此,Eh+Dr 可以看成一个隐式的 human-to-robot retargeting模块,而 Lrecon则直接监督解码得到的机器人动作与真实的机器人动作保持一致:
Dr(zh)≈gr
在此基础上,作者又针对 Human Motion 引入了 Cycle Consistency Loss。
Human Motion 首先经过 Eh 编码得到 zh,然后通过 Dr 得到重建的 Robot Motion。既然此时已经得到了 Robot Motion,就可以再次通过 Robot Encoder Er 将其编码回 Robot Token:
gh→Eh→zh→Dr→g^r→Er→z^r
如果整个 human-to-robot 的转换没有丢失关键的运动信息,那么最终重新编码得到的 z^r 应该与真实 Robot Motion 编码得到的 zr 接近:
Er(Dr(zh))≈zr
因此:
Lcycle=∥Er(Dr(zh))−zr∥2
也就是说,Lcycle 进一步要求 Human Motion 在经历"编码 → Robot Motion 解码 → Robot Motion 再编码"之后,仍然能够回到正确的 Robot Motion latent representation。
到这里解决的其实仍然是动作表示问题,还没有真正解决"如何控制机器人执行动作"的问题。
前面的 Robot Motion Decoder Dr 接收 token z:
g^r=Dr(z)
它回答的是: 这个 token 所表示的机器人动作应该是什么样子?
也就是说,Dr 输出的是 Robot Motion representation。但真正控制机器人时,仅仅知道目标动作是什么样子是不够的。机器人还必须考虑自己当前处于什么状态。因此 SONIC 又设计了另一个 decoder:Robot Control Decoder Dc。与 Dr 不同,Dc 不仅输入 Universal Token z,还额外输入机器人的proprioceptive state,即本体状态 stp:
at=Dc(z,stp)
这里可以把两个输入分别理解成:
z=“机器人想要做什么动作”
stp=“机器人现在处于什么状态”
而 Dc 输出:
at=“机器人现在应该采取什么控制动作”
论文中的 stp 包含机器人的 joint pose、joint velocity、root angular velocity、gravity vector、previous action 等本体感知信息,并使用了一段历史状态。最终输出的 at 是 target joint positions,再交给底层 PD controller 执行。为什么 Dc 必须额外输入当前机器人状态?
因为即使目标动作 z完全相同,机器人当前所处的状态不同,下一步需要采取的控制动作也可能完全不同。
例如目标都是"抬起右腿",但如果机器人当前稳定直立,与机器人已经向左倾斜时相比,为了完成同一个目标动作,各个关节下一时刻应该采取的控制显然不同。因此 Dc 真正学习的是:
目标动作+机器人当前状态→当前应该采取的控制动作
对于 Dr,训练相对直接。因为数据集中存在对应的 Robot Motion gr,所以我们有明确的监督目标,可以直接要求:
Dr(z)≈gr
但是对于 Dc,情况不同。
数据集虽然告诉我们"机器人应该做出什么 motion",却没有告诉我们:在机器人当前这个具体的物理状态下,各个关节下一时刻究竟应该输出什么,换句话说,并不存在一个明确的 ground-truth action at∗,因此无法简单使用下面这样的监督学习:
∥Dc(z,stp)−at∗∥2
所以作者采用了强化学习。
Dc 根据目标 motion token z 和当前机器人状态 stp 输出 action:
at=Dc(z,stp)
机器人在物理模拟环境中执行这个 action:
(stp,at)→Physics Simulator→st+1p
执行之后,再观察机器人实际产生的运动与 reference motion 是否一致。
如果机器人能够准确跟踪 reference motion,同时保持稳定和平滑,那么获得较高的 reward;如果跟踪误差较大、动作不稳定甚至失去平衡,则获得较低的 reward。
因此强化学习并不是直接告诉 Dc: **"正确的 action 应该是什么。"而是在告诉它:"你刚才选择的这个 action,最终产生的结果有多好。"**PPO 根据这些 reward 不断更新控制策略,使得机器人以后遇到类似的目标动作和身体状态时,更倾向于采取能够获得较高累计 reward 的 action。最终学习的是:
(z,stp)DcatPhysicsRobot Motion
论文最终将四种 loss 联合优化:
L=LPPO+Lrecon+Ltoken+Lcycle