GenHOI: Contact-Aware Humanoid-Object Interaction by Imitating Generated Videos without Task-Specific Training
Loading...
对action的表示:点轨迹(盆骨+两只手|MotuBrain)。Behavior Foundation Model(保持平衡和步态自然)
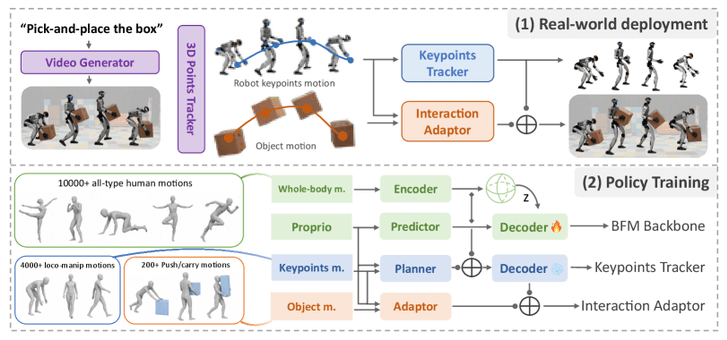
三阶段渐进式训练法(Progressive Training)
因为交互数据太少,作者将训练拆成了三步(见 Figure 2 底部)():
- 第一阶段:训练 BFM 主干。在超过 10,000 段(约 68.5 小时)海量人类自身运动数据集(不包含物体交互)上训练,让机器人学会怎么自然地走、跑、平衡。
- 第二阶段:训练关键点追踪器(Keypoints Tracker)。在一些带有上肢操控的运动数据(约 8.86 小时)上训练,让机器人学会只看 3 个点也能一边走路一边伸手。
- 第三阶段:微调交互适配器(Interaction Adaptor)。在极少量的实际交互数据(仅 0.43 小时)上,利用简单的追踪奖励微调,让机器人学会和箱子接触时的力量微调,实现精准抓取。
真实世界部署流水线(Real-world Deployment)
在实机部署时(以 Figure 1 为例):
- 输入:给系统一张现场的 RGB 照片,并输入文字指令:“把右边的棕色箱子搬到右边”()。
- 想象(Imagine):视频生成模型(如 Seedance 2.0)根据图片和文字,“脑补”出一段机器人过去搬箱子的物理短视频()。
- 提取:通过视觉分割和追踪算法,提取出视频中机器人双手、底座以及箱子的 4D 轨迹()。由于视频没有绝对深度,利用动捕系统(Mocap)进行初始帧的缩放校准。
- 进现实(Real):机器人实机直接运行策略,成功把“想象”中的动作变成了现实中的物理抓取()。