GRAIL: Generating Humanoid Loco-Manipulation from 3D Assets and Video Priors
Loading...
从真实场景视频中重建可供机器人使用的 4D 轨迹虽能提供广泛的视觉覆盖,但需要从模糊的单目观测中推断出相机参数、尺度、物体几何、人体形态、接触关系以及世界坐标系下的运动。与其从非受控视频中重建完整的 3D 交互过程,我们能否先明确设定 3D 场景,再利用视频生成先验来合成多样化的交互数据,从而服务于人形机器人的策略学习?
Blender中初始化场景:一个人类asset,一个奖杯,拍照
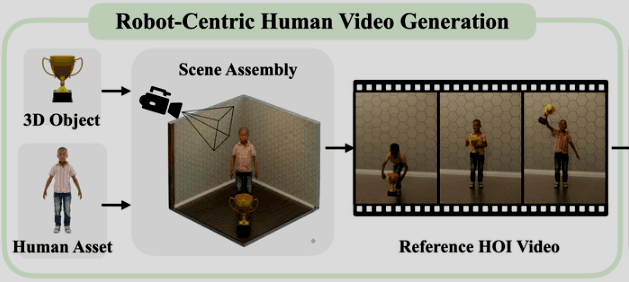
视觉语言模型生成prompt:“一个小孩走过去,用右手把桌上的金杯举起来”
视频生成模型生成5-10秒的视频
4D轨迹重建和重定向(提取smplx用的GENMO,然后因为他们的场景是虚拟环境,有一些参数已知,可以特殊的trick对齐;smpl重定向action使用的就是GMR)
模拟世界到现实的domain gap:物理动力学的gap(SONIC);视觉外观gap(VIRAL,蒸馏,视觉域随机化,相机对齐)