传统的视觉-语言-动作 (VLA) 模型通常只学习从"当前观察"到"机器人动作"的直接映射, 但缺乏对物理世界在动作干预下如何演变的建模.
WAM 则将"预测性的状态建模"与"动作生成"统一起来的基础模型. 它不仅生成动作, 还预测执行这些动作后未来环境的状态变化(即针对未来状态和动作的联合分布进行建模). 通过引入物理世界的预测能力, 模型能获得更强的物理理解和泛化能力.
原定义涉及到很多公式定义, 让notebook结合一个具体的场景来讲. 用户上传了一张"虚拟角色站在房间里"的图片, 并输入指令"镜头向右平移, 同时角色向前走".
- VLA(只输出控制代码): 系统接收到图片(当前观察 o)和 Prompt(语言指令 l)后, 直接输出一段"控制参数"或"脚本指令"(动作 a). 特点: 它根本不生成最终的视频画面, 它只是一个"操作指令翻译器".
- 世界模型(WM): 系统接收到图片和指令后, 直接在像素层面预测未来, 为您生成了一段精美的, 符合物理直觉的视频(未来状态 o′), 像Sora, Kling等食品生成模型就是世界模型. 局限: 它只给你"看"结果(一段MP4视频). 如果您想把这段生成的视频放进游戏引擎里去单独提取镜头的移动轨迹, 或者角色的骨骼动画参数, 它做不到, 因为它不输出"动作/控制参数".
- 世界动作模型 (WAM): 系统不仅生成了一段"镜头右移, 角色前进"的高清预测视频(世界建模), 同时, 它还输出了与这段视频画面严格对齐的摄像机轨迹参数和角色动画代码(动作生成).
然后讲了为什么这在音视频领域有意义, 在复杂的音视频生成工作中, 有时我们不仅需要生成像素画面, 还需要模型在潜在空间中输出能被下游软件直接执行的控制参数. WAM 能够确保"生成的视频画面"和"输出的控制参数"在数学和因果逻辑上是完全一致的.
- VAM. VAM的优化目标专门针对像素级视频帧的合成. VAM 是 WAM 的一个子集, 它被死死绑定在了"视频"这种特定的模态上, WAM 命名中的"World"一词, 强调的是模型内化了环境底层的物理定律和因果动态, 它认为视频仅仅是建模世界的一种可选形式, 也可以是潜在空间表示, 3D点云等.
- Video Policies. 视频策略仅仅是借用视频生成模型的架构来提取特征, 然后输出控制动作, 这个和VLA特别像, 输入text指令, 输出动作指令, 区别在于VLA的基模一般是语言模型, Video Policies的基模是视频扩散模型.
- AWM. 两者在数学和功能上非常相似, 但 WAM 的命名代表了对具身智能系统定位的战略转变. AWM的核心名词是世界模型, 而世界动作模型将"世界"与"动作"提升到了同等重要的核心地位, 强调其作为机器人完整基础模型的独立身份.
提问
在读到VAM和WAM的区别时, 为了大模型这样一个问题, Sora, Kling优化的目标也只是视频, 为什么它们可以称为世界模型, 大模型的解释是
- 它们内化了物理世界的运行规律 (Rich Physical Priors) 虽然它们的直接目标是生成像素,但在学习海量互联网“视频-文本”对的过程中,这些模型实际上获取了关于物体、场景、物理交互、相机运动以及时间动态的丰富先验知识。也就是说,它们不仅学会了“画画”,还掌握了“重力如何作用”、“物体碰撞后如何运动”等底层物理常识。
- 它们具备预测环境未来演变的能力 (Predictive Capabilities) 论文对“世界模型”的本质定义是:能够内化物理环境的因果动态,并预测未来状态演变的函数。Sora 和 Kling 能够基于一段高级的语义描述(如Prompt),生成一段符合物理直觉的视觉未来画面。论文指出,这种能力提供了一种在语言指令下对世界演变进行建模的自然接口。由于它们展现出了丰富的世界知识和强大的预测能力,因此实际上已经有效地充当了强大的多模态世界模型。
简单来说: 它们虽然只输出视频,但它们输出的视频是“讲物理因果逻辑”的。在具身智能领域,研究人员把它们看作是一个“拥有世界物理常识的虚拟引擎”,而不仅仅是一个视频生成器。
额, 所以VAM和WAM里面的video 和 World的区别, 我觉得是一个很虚的东西, 我的数据量大, 模型参数多, 我认为他学到了物理知识就是世界模型, 如果你参数少只能完成某个特定任务, 你就叫做视频模型, 我觉得他们就是这样区分了.
- 早期探索打破传统模仿学习的局限, 有几种条件注入的方式, FiLM, cross attention和简单拼接.
- LLM的注入与爆发, 他们尝试将LVLMs的权重直接拿来用, 这让机器人瞬间拥有了互联网级别的高级语义理解和逻辑推理的能力, 动作表示分化成了Token化和连续扩散两个流派.
- 感知升级, 不再局限于看2D图像, 还看3D几何信息, 深度图, 力觉和视觉反馈.
局限: VLA仍然是一种反应式的映射机制, 它并没有理解物理世界是怎么运作和演变的. 由于缺乏预测未来环境动态的能力(缺乏世界建模), VLA 在需要深度物理理解和面对未见过的复杂操作时, 泛化能力会大打折扣. (做题机器, 不懂原理)
定义存在争议, 但是共识是世界模型是一种内部表示, 它模拟环境动态和行动的影响. 基于这种表示, 它可以预测行动的后果, 从而实现模拟, 决策和规划.
这类模型专门用来描述物理环境如何响应智能体底层的控制信号而发生演变. 给定当前的观测状态 o 和执行的动作 a, 模型会预测环境未来的状态 o′, 即对 P(o′∣o,a) 进行建模. 它捕获了动作对环境动态的因果影响.
显式世界模型在像素层面预测未来的视频帧, 它最终可以输出人类可见的 RGB 像素画面. 早期探索通过预测像素移动, 密集光流, 然后视频生成技术爆发, 走向了端到端的方法, 但是最终都是输出视频.
为了克服生成高清像素带来的巨大计算开销, 隐式世界模型完全放弃了在像素层面预测未来, 将当前预测的画面压缩到一个紧凑的潜在空间, 在这个空间内学习和预测演变. 我的目标是要最终视频的, 这里就不细看了.
这类模型使用自然语言作为更高级, 更抽象的引导条件. 它们不需要输入精确的电机转动角度, 而是通过学习海量的"视频-文本"对, 获取了关于物体, 场景, 物理交互, 相机运动以及时间动态的丰富先验知识.
GAN -> UNet -> DiT -> Latent Space(VAE).
讲了世界模型应用到具身领域做得一些工作.
- 从与动作标注的海量人类视频中学习物理规律. 因为互联网上存在海量的人类操作视频, 但这些数据没有机器人的底层控制代码, 为了利用这批数据, 提取潜在动作或者是关键特征.
- 提升生成的物理感知能力与多视角一致性. 动作与画面精准对齐, 多视角与长期一致性, 强化物理知识.
- 拓展感知模态. 从纯 2D 视觉走向 3D 与触觉. 2D预测走向3D预测, 然后融入触觉反馈.
探讨了世界模型是如何在外部系统中给VLA"打辅助"的.
用于辅助学习. 在训练VLA策略时, 真实机器人数据的收集成本极高且存在物理试错风险, 世界模型: 1) 辅助模仿学习. 模仿学习及其依赖有限的专家演示数据, 世界模型可以作为一个强大的数据合成器, 扩充VLA数据集; 2) RL的替代环境. 真实世界做强化学习昂贵且危险, 世界模型可以充当虚拟物理沙盒; 3) 自动化奖励建模. 直接评估VLA的操作轨迹与预测成功画面之间的潜在对齐度, 免去人工设计的麻烦.
用于辅助评估. 感觉和辅助学习的内容有重叠, VLA在物理机器人上表现耗时昂贵不安全, 物理模拟器存在严重的仿真到现实的差距, 通过世界模型构建虚拟测试场, 还能故意合成一些系统没见过的极端场景或安全临界问题.
类比music to dance任务中的两步式.
把"直接让人眼能看懂的像素级视频帧(即预测的未来画面)"作为连接"世界模型"和"动作模型"的中间桥梁.
基于学习的动作提取. 通常会训练一个独立的动作解码器, 让它看着生成的未来视频, 推导出"要实现这个画面, 机器人该怎么动". 发展的方向是解决长视频累计误差, 丰富规划的信息维度(不再只生成RGB彩色视频, 还加入深度图和表面法线等集合线索), 还与其他大模型深度结合, 比如π0.7用预训练VLA替换IDM, Veo-Act设计了门控机制, 在靠近物体时把控制权交给VLA, 弥补世界模型精度不足的问题.
几何式动作提取. 从视频提取出optical flow或者pose tracking(3D坐标, 6D位姿), 直接去把物理运动轨迹算出来.
核心动机是觉得像素级的视频生成的计算开销太大, 研究人员发现扩散模型在生成过程中产生的中间"潜在特征", 其实已经包含了用于规划的物理动态信息, 因此根本没有必要把这些特征解码成人类肉眼可见的 RGB 画面.
(追求极致推理速度)VPP在潜在空间中预测未来的单步特征序列, 用一个轻量的策略网络从中提取动作; S-VAM引入自蒸馏技术, 实现一步前向传播; (提取中间半成品)Video Policy专门训练了一个额外的动作网络, 直接读取视频模型中间层的隐式特征来输出动作; mimic-video使用不完全去噪策略, 在扩散的中间阶段截取特征, 绕过完整的视频生成路径;(过滤视觉噪音拓展多模态)MWM不预测RGB像素, 而是预测未来的语义掩码; OmniVTA扩展到视觉-触觉领域, LAPA和villa-X利用无标注的纯视频数据进行无监督的"latent action"预训练.
提问
问了一个问题, world action model不是要同时生成视频和动作吗, 那么像mimic-video, VPP, S-VAM还能叫world action model吗, AI的回答是
答案是:它们依然是百分之百的世界动作模型(WAM),因为 WAM 的核心要求是预测“未来的状态(States)”,而不是非要生成“肉眼可见的视频(Video/Pixels)”。
- WAM 对“预测未来”的宽泛定义 在论文第 2.1 节对 WAM 的正式定义中,明确指出模型必须具备“前向预测建模”的能力,即生成未来状态 o′。但论文紧接着强调,这种建模可以表现为显式的视觉预测(如像素级的视频帧),也可以表现为“隐式的物理表示(例如基于物理的潜在空间/Latent Spaces)”。
- 回顾 VAM 与 WAM 的“一字之差” 正如我们之前讨论的,如果一个模型被死死绑定在必须生成 RGB 像素画面上,那它叫视频动作模型(VAM)。而 WAM 里的“世界(World)”代表的是内化物理规律,它独立于具体的模态(modality-independent)。生成视频仅仅是呈现世界运转的其中一种“代理方式”,而不是唯一方式。
在这类架构中, 未来的世界状态和动作在一个统一的模型中进行预测, 世界建模和动作生成在训练过程中作为联合监督目标. 核心设计问题是世界状态和动作生成如何在这个共享的预测系统中耦合.
- 显式解耦表示. 模型承认"视觉画面"与"物理动作"时完全不同的两种数据形式, 因此, 它在底层使用统一的 Transformer 大脑, 但在输出端分叉成两个独立的输出头, 一个专门用来输出连续的动作参数, 另一个用来回归离散的视觉补丁(输入是动作控制信号要过MLP进行升维). 它通常通过插入特殊的控制 Token 如 [ACT], [OBS]来引导信息流向不同的头
- 统一离散表示. 随着MLLM的爆发, 研究者开始把物理世界的连续动作和高位视觉画面全部强制量化成类似自然语言的离散Token, 然后讲了一些对抗误差累计的方法, 挺有启发的写一下, CoT-VLA先用因果注意力脑部视觉思维链, 再全注意力同步生成动作; WorldVLA强制当前动作只能根据历史视觉上下文设计; F1使用MoT, 不同的专家网络解耦两种生成的路径.(可以注意到多为mask掩码设计, 精细的mask设计可以作为一个点)
- 预测性潜在表示. 逐像素生成高清画面消耗算力, 模型还会去拟合背景光影变化(不重要), 这个流派典型的VLA-JEPA, 它提取连续的潜在动作 Token 来引导模型预测未来被编码好的特征表示.
阅读重点!!!
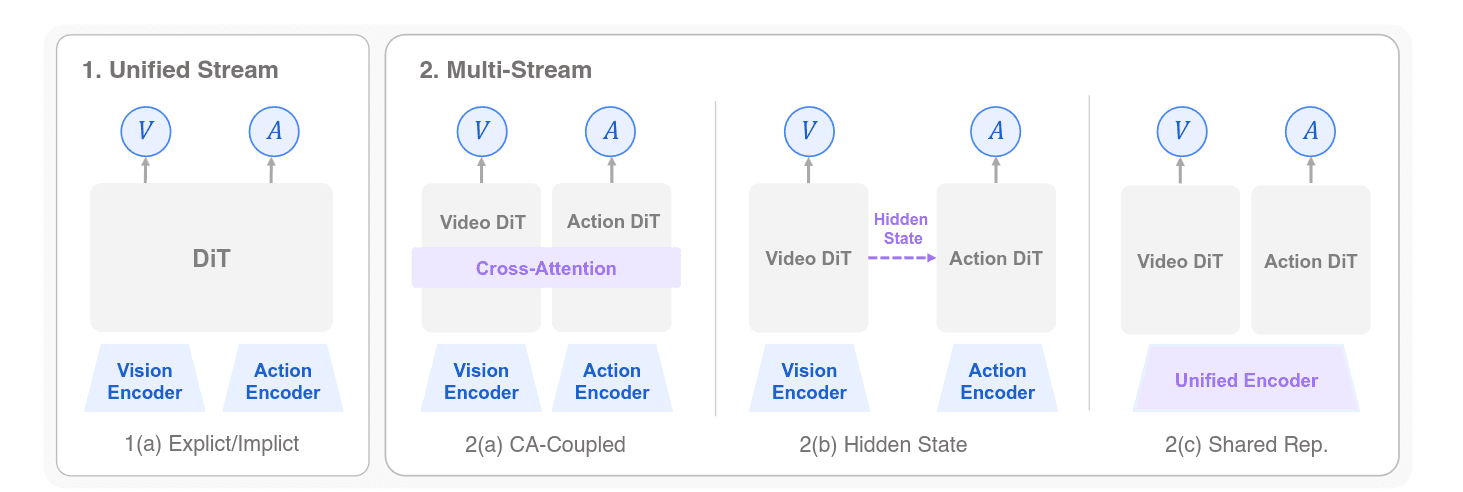
文中画了一个图, 也列举了代表论文, 后续会细读的.
单流架构把世界特征和动作特征塞进了同一个网络主干里进行联合去噪, 它们共享同一个潜在空间和注意力机制. 分成显式和隐式. 显式在输出动作的同时, 必须显式生成未来的视觉画面, 如DreamZero和Cosmos Policy直接在Wan2.1上把动作和视频特征放在一条序列里联合训练. 隐式为了提高效率, 不再强制要求画出未来画面, 比如FLARW和FRAPP, 不强迫重建未来的像素画面, 在抽象的潜在特征层面学习未来的浓缩表示, 有future token的概念, 就是未来画面的浓缩信息.
双流结构分为cross attention coupling, hidden-state coupling 和 shared representation.
- Cross-Attention Coupling. 两个分支各自独立去噪, 但在生成的过程中, 不断地通过"交叉注意力机制"互相偷看对方的信息.
- Hidden-State Coupling. 这是一种"单向传递"的方式. 视频分支在特定的去噪步数或网络层, 把产生的中间隐藏状态直接丢给动作分支作为条件.
- Shared Representation / Unified Encoder. 在数据刚输入时, 先把视觉和动作融合压缩成一个"共享的底层特征向量", 然后在一个网络里推演这个特征的未来变化, 到了最后输出的关头, 才分叉成两个解码器, 一个还原出视频, 一个还原出动作.
从早期的单一实验室环境发展到现在聚合了数百万条轨迹, 覆盖几十种不同形态机器人的海量数据集, 并加入了高保真的触觉反馈数据.
以UMI为代表, 允许普通人带着带有可穿戴相机的 3D 打印夹爪在真实的日常环境中快速采集数据. 这类数据达到百万规模, 而且包含多视角, 触觉甚至全身移动协调的数据, 既有互联网视频那样极高的查理改进多样化, 又带有机器人亟需的厘米级精确控制指令.
能够获得真实世界很难获取的特权信息, 比如完美的深度, 精确的6D姿态和绝对无遮挡的多视角. 可以通过自动化脚本无限生成海量的场景, 物体的超长任务轨迹, 能针对3D空间+时间的4D动态建模, 还能模拟极其微小的软体形变和触觉反馈.
规模最庞大, 获取成本最低. 先通过看海量的无动作视频, 学习物理先验, 然后通过3D手部姿态估计或运动追踪技术将人类视频转换为带有空间几何轨迹的数据(先有视频, 再提取action). 这类数据有一部分还是可穿戴设备标注, 还有一部分是3D手部关键点, flow和点追踪, 还有一部分是无监督的潜在动作(引用论文都很老24年的不建议碰)
由于 WAM 既要预测未来的环境状态, 又要输出物理控制指令, 因此必须对这两部分进行综合考量.
- 视觉保真度 (Visual Fidelity). 评估生成的视频在视觉上是否清晰连贯. 除了像素级的对比(如 PSNR, SSIM), 研究者还会使用基于深度特征的感知相似度(LPIPS, DreamSim, DINO)以及评估整体视频分布真实度的 FVD 等指标.
- 物理常识 (Physical Commonsense). 画面不仅要逼真, 还得符合物理定律. 这部分专门评估生成视频中的物体动态(例如碰撞, 流体物理, 状态改变等, 相关基准如 VBench-2.0, WorldModelBench)以及运动轨迹的合理性(检查动作是否平滑且符合因果律, 如 WorldScore, EWMBench).
- 动作合理性 (Action Plausibility). WAM 最独特的一项评估. 它追问的是: 生成的视频里是否包含了能被机器人执行的有效动作信息? 比如在 Wow, wo, val! 基准中的"IDM 图灵测试"发现, 很多视觉上非常惊艳的视频, 一旦尝试把它们翻译成底层的机器人控制代码, 成功率几乎为零.
- 通用操作 (General Manipulation). 主要针对单机械臂, 占据了评估生态的主体. 从早期测试基础技能的 Meta-World, RLBench, 一路进化到了考核大规模数据泛化, 长序列任务和语言理解能力的 ManiSkill 3, LIBERO 和 RoboCasa 等大型基准.
- 双臂与人形机器人操作 (Bimanual and Humanoid Form). 针对具有更高自由度的复杂形态机器人. 例如 BiGym 涵盖了厨房清洁等移动双臂任务, 而 HumanoidBench 则提供了基于 Unitree H1 人形机器人的全身运动和灵巧手操作评估.
- 移动操作 (Mobile Manipulation). 要求模型同时具备空间导航和目标操作的能力, 代表基准包括 HomeRobot 和涵盖 1000 种日常活动的 BEHAVIOR-1K.
- 接触与形变操作 (Contact and Deformation). 打破了传统的"刚体"假设, 专门测试模型对非刚性物体(如布料折叠, 倒水等宏观形变)以及需要极高精度触觉反馈交互的控制能力, 这被认为是目前物理建模要求最苛刻的方向.
- 真实机器人评估 (Real-Device). 为了消除"仿真到现实(Sim-to-Real)"的差距, 像 RoboArena 和 Maniparena 等基准直接在物理机器人平台上建立规模化的泛化能力测试.
- 目前有级联式, 联合式等多种架构, 但显式地生成视频是否真的是理解物理所必需的仍然不清楚.
- 目前的 WAM 几乎都在预测纯视觉画面, 但这对于需要丰富物理接触的任务来说是存在盲区的.
- 虽然混入海量互联网人类视频很有用, 但如何科学地配比"人类视频"和"机器人数据"仍然是缺乏理论指导. 需要将人类视频带来的知识进行分层提取: 底层物理常识, 中层因果动态(动作与结果的关系), 高层任务逻辑. 未来的模型需要自动剔除那些机器人硬件根本做不到的人类动作.
- 在执行长时间任务时, 模型脑补的未来画面会产生误差累积, 导致后续动作崩溃, 且生成超长视频的计算成本极高.
- 加上了"预测世界"的任务后, 模型面临严重的"延迟税". 即使是优化极好的 DreamZero 也只能达到 7Hz 的控制频率, 远低于传统 VLA 策略 50Hz 的实时控制标准.
- 目前的评估用视频指标评估"画得好不好", 用任务成功率评估"动作对不对", 但这完全忽略了模型是不是真的因为预见到了未来才做出了正确的动作.
- WAM 强大的"脑补"能力是一把双刃剑. 如果模型非常自信地"脑补"了一个错误的物理未来. 它可能会执行极其危险的动作, 对机器人或人类造成物理伤害.
感受
首先是在写作手法上, 影响很深在给WAM下定义的时候, 它并不是简单的声明几个变量, 然后堆几个公式告诉我们这就是WAM的形式了, 它在与VLA, WM的比较中凸显VAM的价值, 又单独开了一个小节去辨析一些容易混淆的概念, 读起来很清楚.
在method上, 我觉得这篇论文站在了一个更高的视野上, 借助预训练模型的能力, 多种条件注入的方式, 这些在以前的调研中常见的名词, 都出现了, 在一个更大的世界观语境下.
music to dance这篇的故事在这里面找就好了, 然后这篇感觉他的落脚点还是在具身上面, 为机器人/机械臂服务, 但是我的落脚点是视频生成, 明天再读一下AVI的综述好了. 更多的感受写在了内部飞书文档, 后续会在组会上讨论.