ExoActor: Exocentric Video Generation as Generalizable Interactive Humanoid Control
Loading...
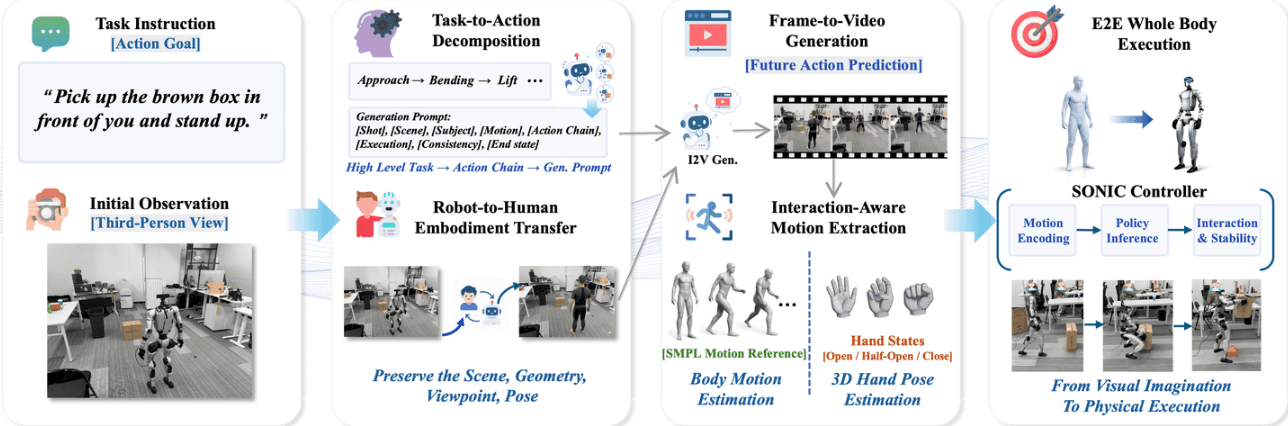
视频生成阶段(Video Generation)
- 机器人转人(Embodiment Transfer):给定一张机器人身处环境的初始第三人称照片,首先利用大模型(如 Gemini 3.1 Pro 图像编辑接口)把画面中的“机器人”完美替换成一个“穿紧身衣的人类”,同时严格保留原本的场景布局、相机视角、人体姿态和比例。
- 任务到动作分解:利用 GPT 大模型将抽象的指令(如“捡起箱子并站起来”)分解成原子动作链(走近 弯腰 抓取 直立)。
- 视频生成:将处理好的人类图片和动作 Prompt 输入到视频生成模型(如 Kling 3)中,让模型生成一段 10 秒的、符合物理规律的第三人称执行任务视频。此时,视频中实际上是一个“人类”在做演示()。
- 交互感知运动估计阶段(Motion Estimation)
视频生成后,系统要从像素级的视频中提取出结构化的三维运动数据:
- 身体运动提取:使用基于扩散模型的 GENMO 算法,从单目视频中恢复出 temporally consistent(时间一致)的 SMPL 3D人体运动骨骼轨迹(包含关节旋转和全局位置)()。
- 手部动作追踪:使用 WiLoR 逐帧估计左右手的 3D 姿态,并将手部状态离散化为三种(张开、半张开、闭合),用于指导机器人的灵巧手抓取()。
- 通用运动追踪部署阶段(Motion Execution)
- 提取出的 SMPL 轨迹和手部姿态虽然好看,但没有物理层面的受力、力矩和平衡限制()。
- ExoActor 引入了大规模人形运动追踪控制器 SONIC 算法()。SONIC 作为一个强力的“物理滤波器”,可以在物理模拟器或真实环境(实验采用 Unitree G1 人形机器人)中,直接消化这些噪声运动轨迹,并在不需要针对特定任务编写奖励函数的情况下,保证机器人动态稳定、 stylistic 逼真地完成执行()。