ω-0: A Latent Predictive World Action Model for Concurrent Humanoid Loco-Manipulation
家庭辅助任务。现有的humanoid将移动和操作解耦(先走到目标位置不动,再执行操作),他们是边移动边操作预测全身,然后好像没有重建未来图像,而是高维嵌入,支持第一视角和第三视角输入。
Loading...
家庭辅助任务。现有的humanoid将移动和操作解耦(先走到目标位置不动,再执行操作),他们是边移动边操作预测全身,然后好像没有重建未来图像,而是高维嵌入,支持第一视角和第三视角输入。
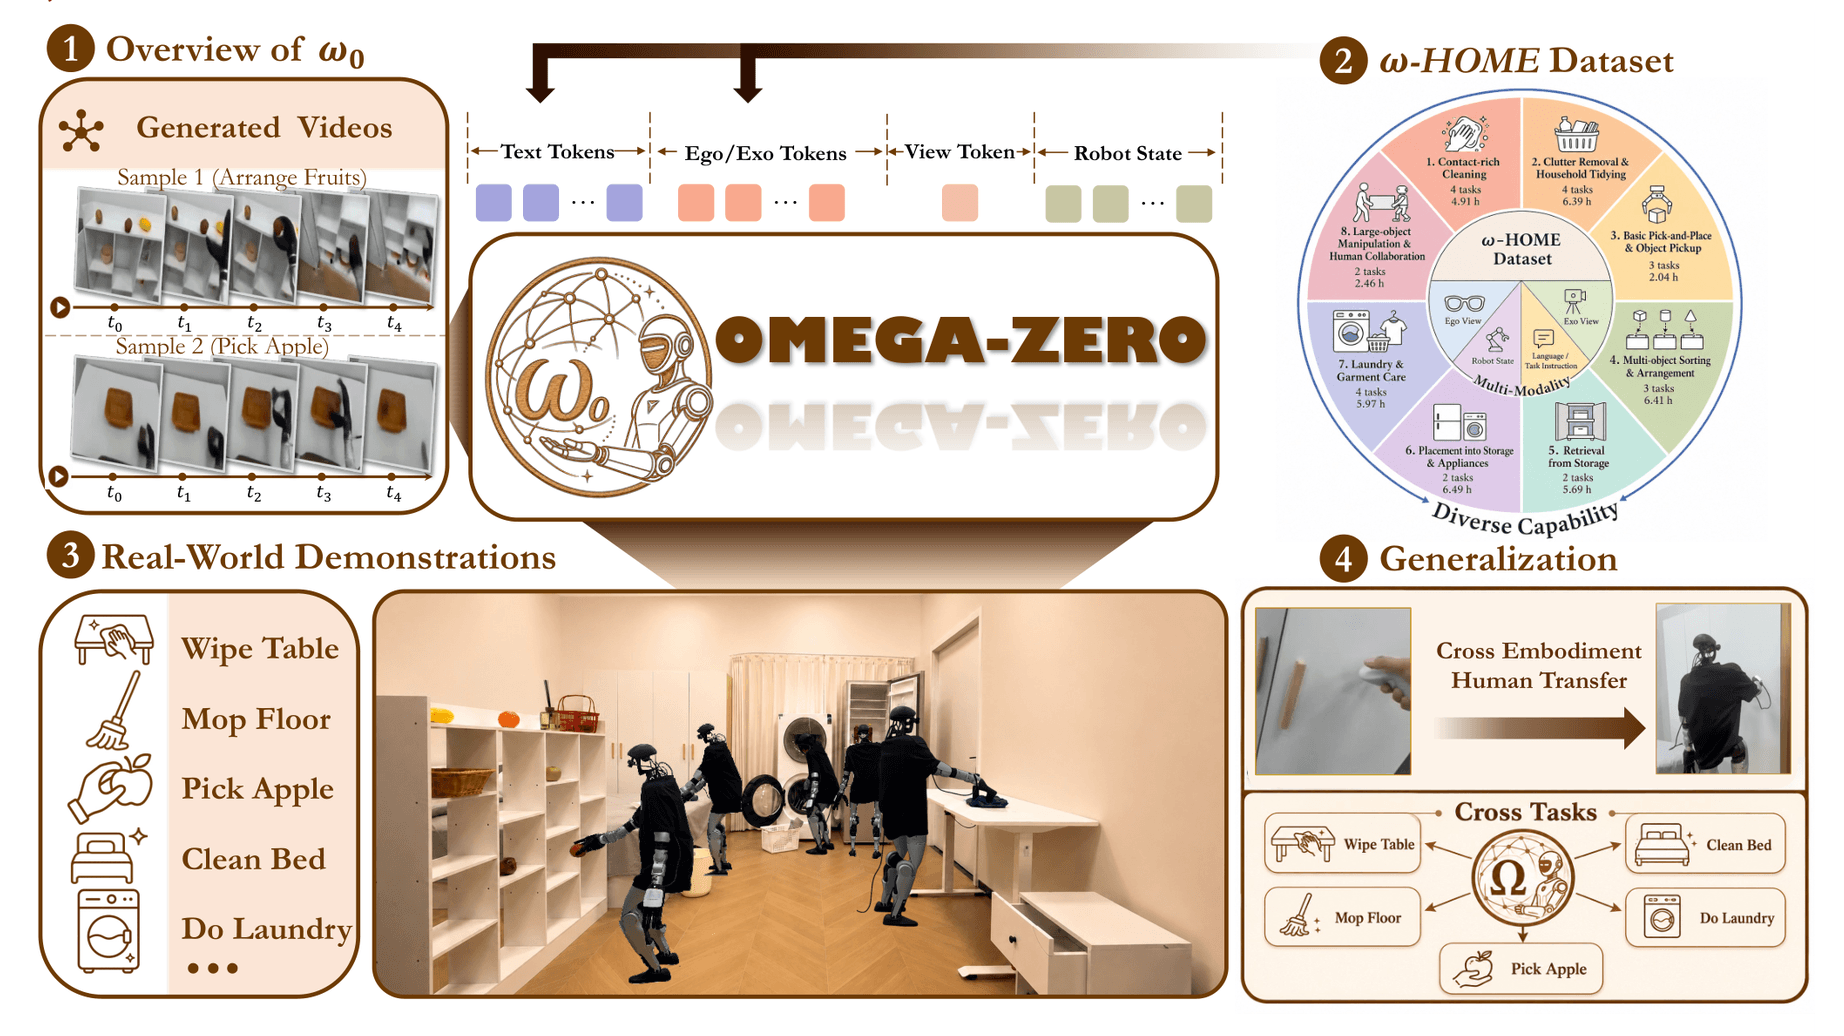
举了一些需要同时移动和操作的例子,需要上下肢协同工作
相关工作中介绍了底盘(与机械臂是独立的模块),humanoid VLA(移动和操作一般解耦)。
wam中的视觉作为额外的监督信号,提出目前的缺陷,以机械臂控制为主,过度依赖预测的视频轨迹,导致时序不一致性被放大,于是它们不将未来预测作为视频生成的目标,而是作为全身动作学习的一种紧凑预测信号
真实人形机器人数据稀缺,人类演示数据无法直接使用,于是统一了视觉-动作表征,基于SONIC仿真回放筛选,不知道是怎么做的后面再看(感觉很有说法),视觉上使用第一人称和第三人称互补
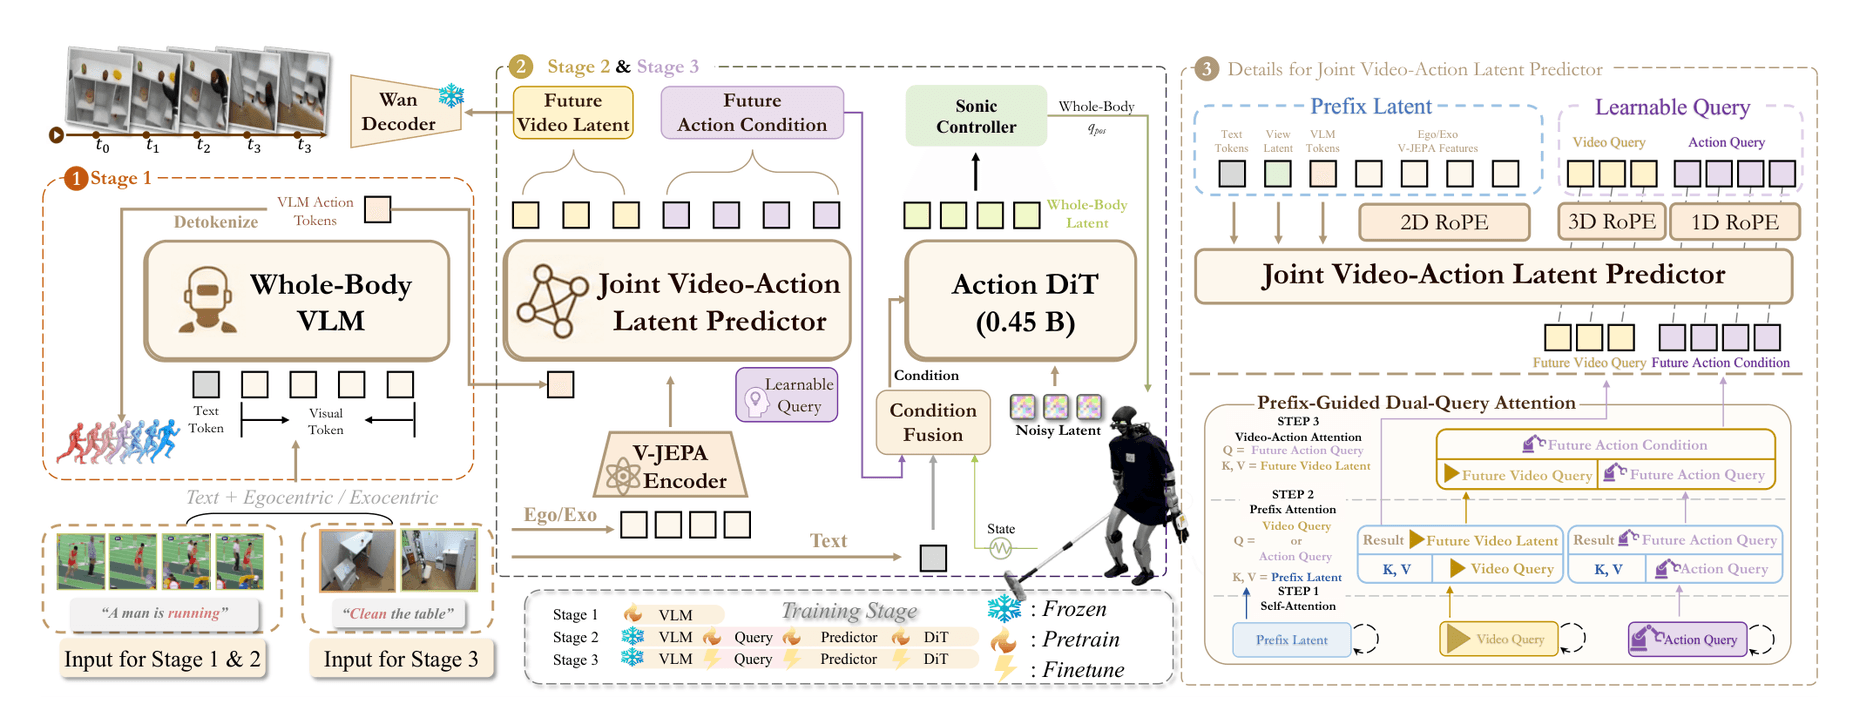
给机器人当前时刻的 ,模型直接预测未来一小段 ,这里的 是 SONIC controller 能执行的 whole-body action latent。
也就是说最终链路是:
我觉得它更像是vla的动作,他们真正想做的是直接生成 action latent,future video prediction 只是训练阶段帮助 action learning 的辅助任务。用的一些方法在wam论文中也很少见,在vla中应该很常见。
先用 FAST 把连续 whole-body motion 离散化成 action tokens,再让 Qwen3-VL 根据当前视觉和语言去预测这些 token,从而逼迫 VLM 的 hidden feature 学到与未来 whole-body motion 相关的语义;后续真正使用的是这个 hidden feature,而不是让 VLM 在部署时输出 action token。
一条具体数据可以怎么理解?
例如有一段第三视角 human video:
第三视角视频:
一个人在房间里向前走并弯腰

文本:
"A man is walking forward and bending down."

对应 SMPL motion:
a_t , a_{t+1}, ..., a_{t+H}
首先 FAST tokenizer 只处理后面的动作:
于是 VLM 真正看到的训练对就是:
如果换成第一视角数据,则变成:
所以输出 action token 的定义不随视角改变,改变的是视觉输入以及 view token。
先利用当前视觉、语言和 Stage 1 的动作语义预测未来视觉 dynamics,再让未来动作表示读取这些未来视觉信息,最后由 Action DiT 根据 future-aware motion condition 生成真正可执行的 whole-body action latent。
Stage 2 的核心目标是:利用当前视觉、语言以及 Stage 1 学到的动作语义,联合预测未来视觉表示和未来动作表示,并最终生成可由 SONIC 执行的 whole-body action latent。
从结构上看,Stage 2 可以拆成两个部分:
- Joint Video-Action Latent Predictor:预测未来视觉 latent 和 future-aware motion feature;
- Action DiT:根据 motion feature、文本和机器人状态,生成真正的 whole-body action latent。
1. Stage 2 的输入条件
Joint Video-Action Latent Predictor 的条件输入一共有四部分:
其中:
- :Stage 1 训练得到的 VLM feature;
- :T5 编码得到的文本特征;
- :用于区分 egocentric / exocentric 视角的 view token;
- :当前图像经过 V-JEPA 编码得到的视觉特征。
2. Video Query 和 Motion Query
除了上述输入,模型内部还定义了两组可学习参数:和分别称为**Video Query 和 Motion Query。**需要注意的是,这里的 Query 指的是 learnable query token,不是 Attention 公式中经过线性层投影之后的 矩阵。
例如可以直接把它理解成模型内部的可学习参数:,,其中 Motion Query 的数量与 action chunk 的长度一致,因此: 可以分别对应未来:,这些 Query 在初始化时并不包含具体场景信息,可以把它们理解为一组等待被填充的未来槽位。
3. 不同 Query 使用不同位置编码
4. Step 1:Self-Attention
Prefix、Video Query 和 Motion Query 首先分别进行 Self-Attention:
这一步主要用于在各自的 token 序列内部建立关系。
5. Step 2:Prefix Attention
接下来 Video Query 和 Motion Query 分别读取 Prefix Condition。
对于 Motion Query:
对于 Video Query:
6. Step 3:Video-Action Attention
完成 Prefix Attention 后,作者进一步让 Motion Query 去读取 Video Query:,同时:,在这一步中:,而:,,因此可以理解为:“每一个未来动作 Query,都去读取模型预测出来的未来视觉 dynamics。”,最终得到:,它已经不再只是根据“当前状态”得到的 motion feature,而是进一步结合了:“当前动作可能导致怎样的未来场景变化。”,因此:,可以称为 future-aware motion feature。(可以发现主干一直是动作token,video token只是辅助生成的动作更准确)
7. Joint Predictor 并不会直接生成最终 Action Latent
Joint Video-Action Latent Predictor 的动作侧输出 ,并不是最终可执行的 action latent。
它只是,或者更准确地说,接下来还需要结合文本特征和机器人状态。机器人状态经过 state encoder:,然后经过 condition fusion 得到真正用于 Action DiT 的条件:
8. Action DiT 生成真正的 Whole-Body Action Latent
真实 future action latent 记作,训练时先向其加入 Gaussian noise:
Action DiT 输入,预测 clean action latent 。这里采用的是,因此 Action Loss 为,最终 Stage 2 的训练目标是 ,也就是说同时学习和
基本沿用 Stage 2 的网络和训练目标,只是把训练数据换成真实机器人轨迹,并额外加入 RTC 来解决连续控制时相邻 action chunk 的衔接问题。注意一点w-home数据集是开源的,有40个小时的真机,包含第一视角和第三视角的数据
选了11个任务,每个任务反复执行十次。指标是成功率,执行10次成功了几次,还有个指标是每个任务可能是1,2,3,4一共四小步,记录每一步的成功与否。
然后它还练了两个版本,一个版本只用第一视角视频,第二个版本用了第一视角和第三视角的视频,结果发现版本二效果更好,说明第三视角视频对 whole-body locomotion 更有帮助。
感受
要我自己回顾这篇论文,stage1是一个很vla的模块,给图片和text指令生成动作(但真正取的是中间隐变量特征),然后stage2偏向wam,用视频指导动作生成。尝试根据首帧和stage1的隐藏特征加上text指令去生成视频,使用gt 视频监督,然后再去根据预测的视频去指导动作生成。在这个过程中就涉及一些attention,query设计。stage3就是使用真机数据再训练,然后需要注意一下它的action是怎么表示的,这里需要专门说一下,stage1是统一使用smpl表示,学习的离散化空间也是smpl的空间,无论数据来自 public human motion,real robot teleoperation,3-point human control,最终用于 Stage 2/3 Action DiT 的目标都落到 SONIC-compatible whole-body action latent
然后其实引发了另一点思考,我们发现dreamzero和motubrain这种非常wam的方法,在推理加速时也会用到一个trick,后期只生成动作,video生成冻结,其实我不太清楚它们出于速度的考虑,还是说大家在骨子里认为生成视频太重了,直接生成动作更work。为什么我会觉得这篇更篇vlm,包括之前读的cosmos3,它们都没有用世界模型基模哎,cosmos3的视频分支是一个vlm,这篇w-0好像是自己初始化的,它还没有展示视频生成的效果,按道理它是可以解码出视频看看的。